今年 7 月初,我用十天时间让 Claude Code 替我做了一个 Office 文档碎片恢复工具。先说清楚它是干嘛的:公司里有取证、数据恢复、IT 运维几个部门,经常要从一块格式化过的硬盘、一个删了文件的 U 盘、或者一份磁盘镜像里,把当年的 doc、xls、docx、xlsx 捞回来。市面上的通用工具(PhotoRec 之类)只会做连续数据的雕复,一旦文件被切成几片散落在盘上就基本放弃了。我们要的恰恰是后面这半截:把散落的碎片重新拼成一个能打开的文件。这是整个项目的立身之本。
开工那天是 7 月 3 日。我的开场白大意是:我想写一个软件,这个文件夹里已经有一份和别的 AI 聊出来的 plan,你先检查这些 plan,看里面有没有错、是不是最优路径、有没有更好的方案。几句话补了边界:C++、主跑 Windows;开源库随便用,这是公司内部自用、非商用的工具,我们是正规公司、有安全授权;性能优先,要同时喂饱几个部门;交付给业务员的是纯 GUI、能离线跑的程序,不要命令行。
那份别的 AI 写的方案,错得很密
手头那份《完整框架》有一千四百多行,第一眼很唬人:十层分层、各种格式字段表、伪代码一应俱全。我让 agent 开了几个子代理,拿着微软的官方规范逐条去核框架里的格式常量。核完的结论挺扎心:方向是对的,但它是一份"未经校对的格式知识汇编",不是工程计划。
错得最密的是格式常量。两轮复审一共揪出十五处照抄必错的硬伤,举几个有代表性的:
- CFB(老 doc/xls 的复合文件容器)的文件头字段表,从某个偏移起整体错位,还凭空发明了一个官方规范里根本没有的字段。照它建模,头都读不对。
- 那套扇区链的哨兵值(标记链尾、空闲的几个 0xFFFFFFFx)整体偏移了 1,而且和框架自己给的伪代码自相矛盾:同一份文档里一处写错、一处写对。
- xls 里装着所有字符串的 SST 记录,框架说"靠 EXTSST 辅助定位"。实际上任何超过 8224 字节的记录都得靠 CONTINUE 接力续写,SST 几乎必然超长;不处理 CONTINUE,任何真实的 xls 都会解析失败。EXTSST 只是个哈希索引,不管定位。
- Word 正文提取,框架说"从 fcMin 顺序读 ccpText 个字符"。这是 Word 95 的老黄历;Word 97 以后正文不连续存了,必须走 piece table 按表重组,否则遇到快速保存过的文档,读出来就是一堆乱序错字。
- exFAT 的已删除文件,框架教你搜 0xC0/0xC1。实际上文件一删,那组目录项的"在用"标志位会被清零成 0x40/0x41,按原文搜,所有已删文件一个都捞不着。
还有一类是"缺机制"。框架通篇没有技术栈、没有里程碑、没有测试语料方案,也没提只读取证这个取证工具的命根子。一些实现上绕不开的东西它压根没写:ZIP 的 data descriptor(这种文件头里的大小字段是 0,真值在数据区后面)、分块扫描时签名跨块必漏所以块间要重叠、Deflate 流从中段重新同步解码的办法。这些后来都成了关键模块。
所以这份方案不用推翻重来,要做的是修错、补机制、工程化。agent 把那份框架从 v4.0 一路修订到 v5.1,十五处硬伤连同十几处新增机制全部落进文档,旧版留档对照。这一步花掉了开工第一天的大半,但它值:后面所有解析器都照着这份修订版写,没有再返工过格式常量。
把"解密"从需求里拿掉
有件事值得单独说。最早我自己给的需求里是带"加密文档的识别和解密"的,但一上手就发现,只要代码往"解密"方向靠,安全模块就反复回退,任务推不动。我想通了一件事:这个工具的价值在碎片重组,不在破解。于是把解密整个从需求里删掉,只留下"识别加标记加跳过":流水线扫到属于加密文档的碎片,认出它是加密的,打个标记,不做任何明文恢复,继续往下走。
这个取舍后来证明是对的。加密文档在磁盘上同样是 CFB 或 ZIP 容器,外层结构照样能被识别、重组、按原名归位,真正打不开的只是里面那层加密载荷。对取证来说,"这里有一个加密的 xlsx、原名叫什么、在哪个目录"本身就是情报,不解密也能交差。本期范围就定死在这:能识别、能标记、能跳过。
架构:复用一半,自研一半
方案审完,架构其实就清楚了。核心的一个取舍是:哪些自己写,哪些用现成的。
文件系统这层,也就是 NTFS、FAT32、exFAT 的解析、分区表、已删除记录的枚举,我决定直接复用 The Sleuth Kit。从零实现三套文件系统,边界坑能淹死人,而且这不是性能热点,是元数据驱动的。省下来的力气全砸在真正差异化的地方:全盘签名扫描、Office 专属的结构解析、碎片重组和修复。这几层没有现成库可用,也正是吞吐热路径。
签名扫描用了 Intel 的 Hyperscan 做 SIMD 多模式匹配,一遍过盘同时找 OLE-CFB、ZIP、BIFF 的头;碎片池落在 SQLite 里,支持断点续扫;OOXML 的解压走 zlib 的 raw inflate。整个引擎是分层的静态库,不依赖任何 UI。
重组这层的设计是整个架构里我最在意的一点:锚点优先,图搜索兜底。碎片重组天然是个组合爆炸问题,n 个碎片有 n 的阶乘种拼法。但 Office 文件里藏着大量确定性的"锚点":CFB 的目录项里写着每条流的起始扇区和长度,BIFF 的记录里有指向各工作表子流绝对偏移的指针,ZIP 的中央目录记着每个条目的偏移和大小。先用这些锚点把碎片骨架定下来,只对锚点覆盖不到的空洞才启用状态机去搜。原来那份框架把图搜索当主路径,那是会爆炸的;把它降成兜底,问题才算可解。
前端只有一个 Qt6 的 GUI,没有命令行产品,交付给业务员的是纯 Windows 桌面程序,离线、全中文、智能默认,尽量不让非技术的人去做技术判断。还有一条贯穿始终的硬规矩:全程只读,物理盘以只读加共享方式打开,恢复的输出禁止落在正在被扫描的那块盘上,GUI 层面强行拦截。取证工具要是把证据盘写花了,这活儿就白干了。
一天从骨架跑到打包
7 月 4 日这一天有点疯。我装好环境,让 agent 从工程骨架开始,一个里程碑接一个往前推:介质接入、分区解析、文件系统元数据层、高性能签名扫描、CFB 解析、BIFF 解析、Word 支持、ZIP/OOXML、多碎片重组、修复评分。我在对话里基本就是"继续 M3""继续 M4"地往前赶,中间穿插真机验证。到晚上,第一个能独立运行的包 v0.1 就打出来了,带着 Qt6 运行时和一套 COM 自动化生成的多版本测试语料,八十多个单元测试全过。
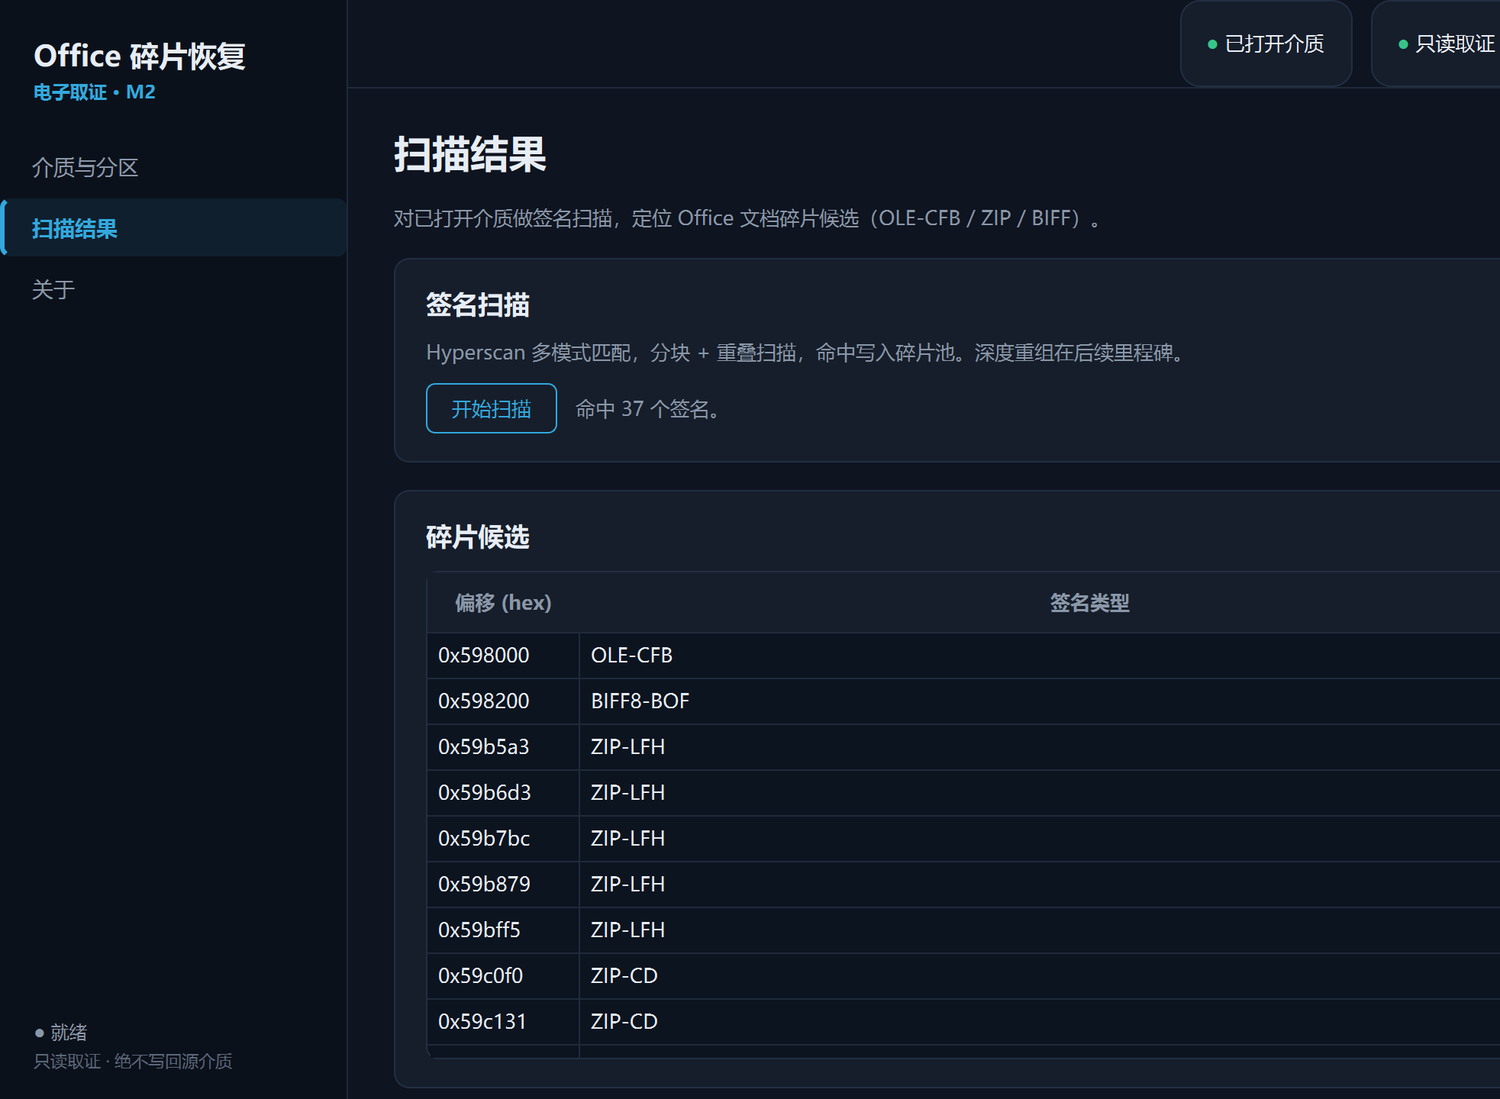
当然,一天跑通十个里程碑,填进去的多半还是接口加桩,真正的肉要靠后面的真机数据长出来。但骨架这天立对了:分层、只读、双管线、锚点重组,这几根梁后面一根都没动过。
7 月 5 日我做了两件收口的事。一是切了另一个模型来做一次独立的代码审查,查之前的实现是不是最优、有没有藏着的 bug;二是针对审查结果做了一轮防御性加固。审查发现架构基本是最优解,但有个系统性短板:项目里明明有一个带边界检查的安全读取原语,四个热点解析器却全绕开它写裸的读内存操作,崩溃缺陷全出在这。取证工具解析的是不可信、损坏、甚至可能是敌意构造的磁盘数据,越界读和整型溢出是头号风险。那天连着两轮对抗式复查,拿真实崩溃样本加模糊测试兜底,前后修了十三类缺陷,其中两个实测能触发进程崩溃,单元测试从八十多涨到九十多。
真正的工程量,在实验室那十一轮反馈里
骨架立起来之后,项目就进入了它真正的形态:实验室那边拿真盘测,反馈一版问题,我改一版,打一个新包。从 7 月 6 日到 7 月 12 日,这样的循环走了十一轮,版本号从 v0.2 爬到 v0.5.0,单元测试从一百出头涨到五百四十二个。
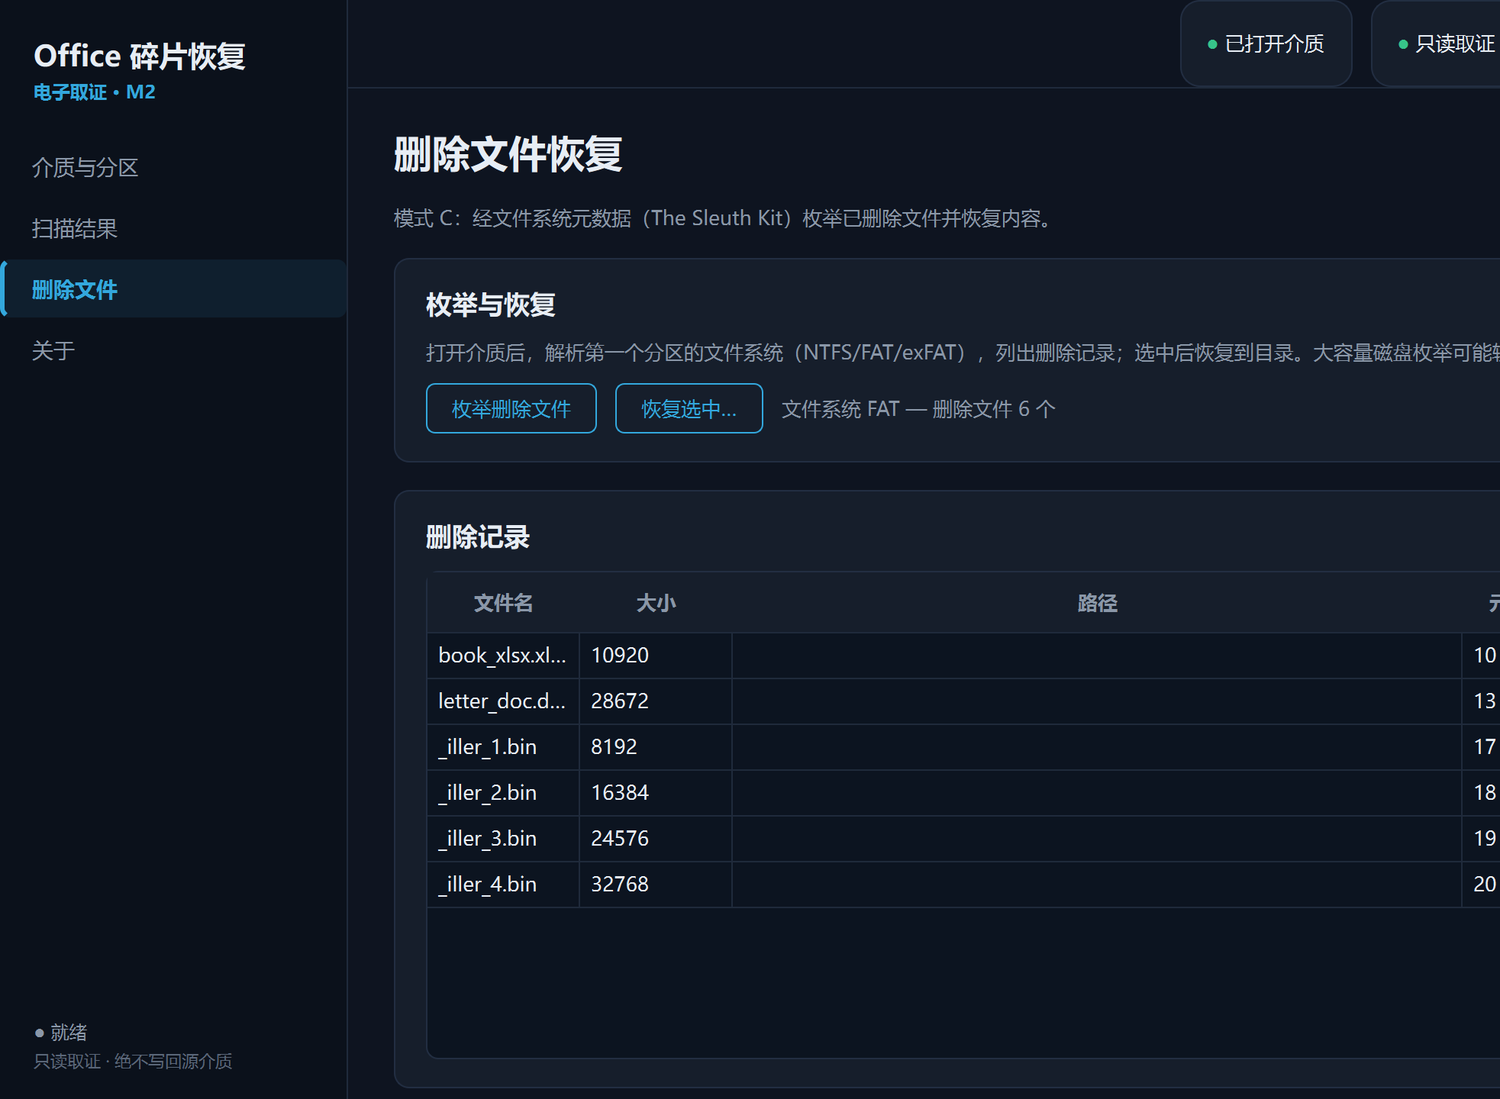
这些反馈没一条是纸上谈兵,全是真机上暴露的。头一批就有九条:恢复要加进度条和日志窗、碎片要能看十六进制、要有专家模式让人工勾选碎片来重组、要有文件修复、重组结果要先在内存里出个列表而不是闷头写盘、百万级碎片时重组半天不结束、还有莫名其妙的闪退。我当时给 agent 定了个调子:每个功能尽量做到完美,将来别返工。所以没急着一条条糊上去,而是先在重组层搭了一根脊柱,一个统一的内存结果模型加一个并行批量重组引擎,让结果窗口、预览、专家模式、导出全都复用它。这根脊柱后面被反复证明搭对了。
有一轮反馈是用户自己贡献了算法思路,我印象很深。当时实验室抱怨千万级碎片重组太慢,在上千万条碎片里来回遍历查找。用户在反馈里专门写了一句,说实验室人员提的解法不一定最优,然后给了自己的想法:利用文件系统分配文件时尽量连续这个特性,先快速扫一遍,把前后连续、确定在一起的碎片直接接好、能出文件的先出掉并登记在案,剩下真正的碎片再去整个剩余碎片池里慢慢组合。这个思路直接落成了两趟式重组引擎,第一趟连续直取、第二趟才做间隙搜索,千万命中的基准从三百多秒压到四十来秒,还顺带找回了旧引擎漏掉的十几个碎片文件。
千万级碎片:从 236 小时到 8 分钟
整个项目里最硬的一仗,是 7 月 10 日那块真盘。实验室说"千万碎片还是不行",给了一块盘让我实测:77GB 的物理大小、244GB 的虚拟容量,一扫,命中两千两百一十万个签名。按当时的口径,这些命中会全部当成重组锚点喂进引擎,实测大概每秒处理十来个,外推下来要跑两百三十六个小时。实验室说的"不行",一点没冤枉它。
四层真因是一层层剥出来的。第一层,OOXML 文件内部每个条目都带一个局部文件头,一个 docx 拆开有几十个,千万级的内部头全被当锚点喂了进去;改成扫描期就地读一下条目名,只有以 [Content_Types].xml 打头的"文档起点"才进重组,锚点从一千万降到一百七十万。第二层,定界失败的锚点会走完 256KB 到 32MB 的整个探测阶梯,读放大惊人;改成以"下一个文档头"为上界,因为文件系统分配不重叠,连续文件必然在下一个头之前结束。第三层,第二趟搜索时相邻锚点窗口严重重叠,同一片盘被重复读几百遍;上一个 512MB 共享块缓存把重复读坍缩成约一遍盘,窗口再按局部头密度自适应,每个锚点从 47 毫秒降到 2.24 毫秒。第四层,介质层单句柄加锁,十六个线程全在排队,改成无锁定位读、结果流式落盘。
四层修完,同一块盘 516 秒跑完,恢复出 1048 个文件,文件名是从内部元数据还原出来的真实业务文档名。从"跑不完"到八分半钟,差了三个数量级。随后几轮补了配套的健壮性:收口闪退(一类模态进度框在收尾时重入事件循环,踩到已释放的对象)、加内存压力调速器(整机内存超过 80% 就自动压缩缓存、限流大窗口并发,重组峰值从 1.2GB 压到 161MB,而且开不开这个保护,恢复出来的字节都逐字节一致,只慢不错)。还有一次是恢复出的 xls 打不开,查下去是一个 Word 文档里内嵌了工作簿,类型判定被内嵌对象抢了,把 doc 误判成 xls,改成只在根存储的直接子项里判类型才解决。
最后卡住的地方:90 分,却打不开
项目停在 7 月 12 日傍晚,停在第十一轮反馈上。这一轮的问题,恰好是整个项目最深的一道坎。实验室发来一张截图和几个样本,说法是:恢复出来的文件里,有一批评分 90 分、标着"优秀",却根本打不开。
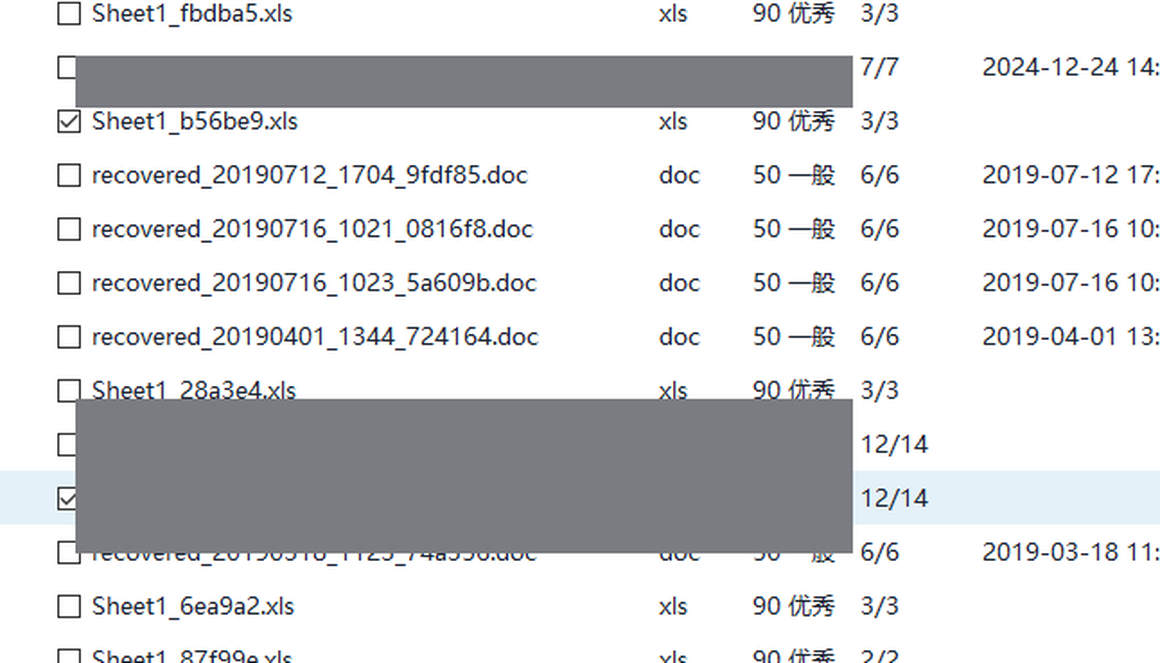
我让 agent 拿 PowerShell 手写了个解析器给那个样本验尸。真相是这样的:那个 xls 的 CFB 外壳是完好的,扇区链能走通、三条流都在,这就是它拿到 90 分的全部依据。但装正文的 Workbook 流在两千多字节处就死了,后面全是别的文件覆写进来的外来数据,一个单元格都没有。更糟的是,解析器在表为空时会好心合成一个默认表头,而旧的评分公式里"正文可提取"是 40 分的大头,这个合成出来的假表头,把这 40 分白送了出去。结构齐全算优秀,载荷死活根本没人问。
这背后是整个评分哲学的毛病:我一直在用"结构完整度"给文件打分,但用户要的是"能不能打开"。这两件事在健康文件上是一回事,在这种被覆写的残件上就彻底分家了。
修法是三管齐下。第一,加一层内容级校验:BIFF 记录链严格顺序走查,量出到底有多少有效字节、多少个真实单元格;Word 用"声明的正文长度和真实提取到的字符数之比";一旦判定主流内容已被覆写,分数直接封顶 25 分,建议里老实写"结构外壳完整但正文不可恢复",合成的假表头不再算正文。第二,让部分恢复的 OOXML 真能打开:Office 拒开这类包的头号杀手其实是"声明了却不存在"的悬空引用,于是给缺失的样式、主题、共享字符串这些可替身部件合成最小占位件,把纯内容部件的悬空引用从关系表里剔干净,最后按现存部件重写 [Content_Types].xml。第三,交付的字节要清洗,把原盘残留的垃圾目录项、别的文件名残迹从输出里抹掉。
改完之后,那个原来 90 分"优秀"的死件样本,重新评成了 25 分"极差",建议写明打不开;而一批真正缺了样式、缺了工作表的残件,经过自愈后被 Excel、Word 真的打开了,这些都用 COM 实际开过验证。那块真盘上的语料端到端跑下来,该开的六个全开,该拒的死件如期拒开。单元测试到这一步是五百四十二个。
停在 v0.5.0
7 月 12 日之后,这个项目就没有再往前走。它停在 v0.5.0,停在"评分和可打开性终于对齐"这个节点上。
回头看,真正耗掉时间的从来不是把文件拼回来这件事本身,骨架一天就跑通了。耗时间的是那十一轮真机反馈,是每一次"看着恢复成功了其实没有"的复盘。这个工具教我的东西,和那份一开始就错得很密的方案是呼应的:格式常量照抄必错,得拿官方规范一条条核;恢复结果看着漂亮也可能是假的,得拿"能不能真打开"去量。两头都是同一个道理,不能信表面。
还卡着几件没动的事,留给下一次。多碎片重组在低质量源上的真打开率还不够高,那块真盘上有一批顶满 32MB 窗口的低质导出,真正能打开的比例不理想,评分系统现在会老实地给它们打低分、默认不勾选,但"打低分"不等于"能救回来"。解密整条线按当初的决定没做,真要做得单独立项。这个工具的下一步,是把低质碎片的重组质量再往上提一截,以及把那十一轮反馈里攒下的规矩,固化成一套测试矩阵,不用实验室再替我踩一遍。