4 月 3 日凌晨,我把 google-ai-edge/gallery 拉到本地,想编一个三星 Galaxy S25 Ultra 专用的版本,让 Gemma 4 E4B 跑在手机的 NPU 上。S25U 是骁龙 8 Elite(SM8750),NPU 是 Hexagon v79。前后做了五次,最后一次是 5 月 30 日。结果是 E2B 在 NPU 上跑起来了,E4B 没有。E4B 卡在模型上:LiteRT-LM 的 NPU 后端要的是为这颗芯片预编译过的模型文件,Google 只发了 E2B 的。E2B 能跑,靠的是从 Google 自己发的 sm8750 版 APK 里取出来的一个 libLiteRtDispatch_Qualcomm.so。这篇里没有 tokens/s:当时只确认了 NPU 后端加载成功、prefill 返回 OK,没有跑基准。
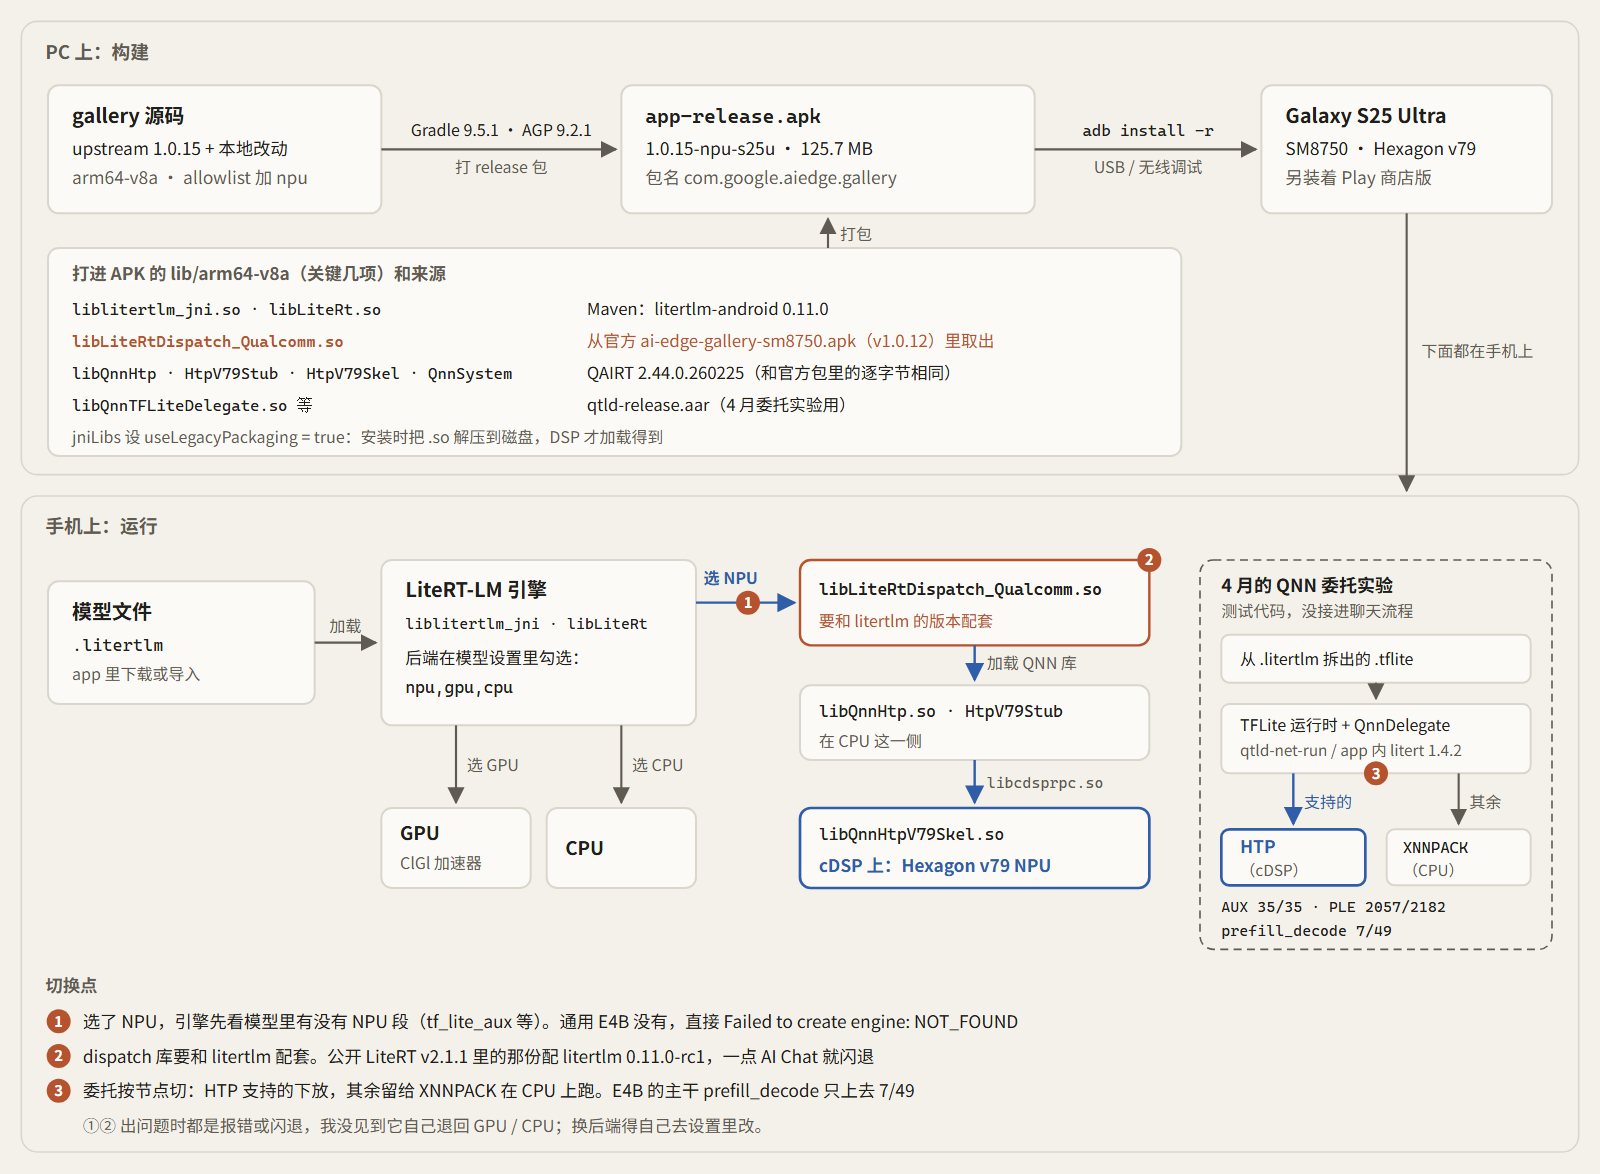
整个过程是我和 Claude Code 一起做的:我拿手机、点 app、往对话里贴文档,它改代码、打包、看 logcat。下面按时间顺序写。先放最后跑通的整条链路,三个红圈是中途卡住过的地方。
第一版:只改白名单
Edge Gallery 的模型列表是一份 allowlist JSON,上游放在仓库的 model_allowlists 目录下,app 按版本号去 GitHub 拉。代码里还留了一个测试用的 TEST_MODEL_ALLOW_LIST 常量,不为空就用它。每个模型的 defaultConfig 里有一个 accelerators 字段,决定 app 里能选哪些后端。
第一版改得很少:build.gradle.kts 里把 ABI 限制成 arm64-v8a,版本名改成 1.0.11-npu-s25u;ModelManagerViewModel.kt 里把 TEST_MODEL_ALLOW_LIST 填成自定义白名单,7 个主要的 LLM 都写上 "accelerators": "npu,gpu,cpu";app 名字改成 Edge Gallery NPU。打出来 84MB。
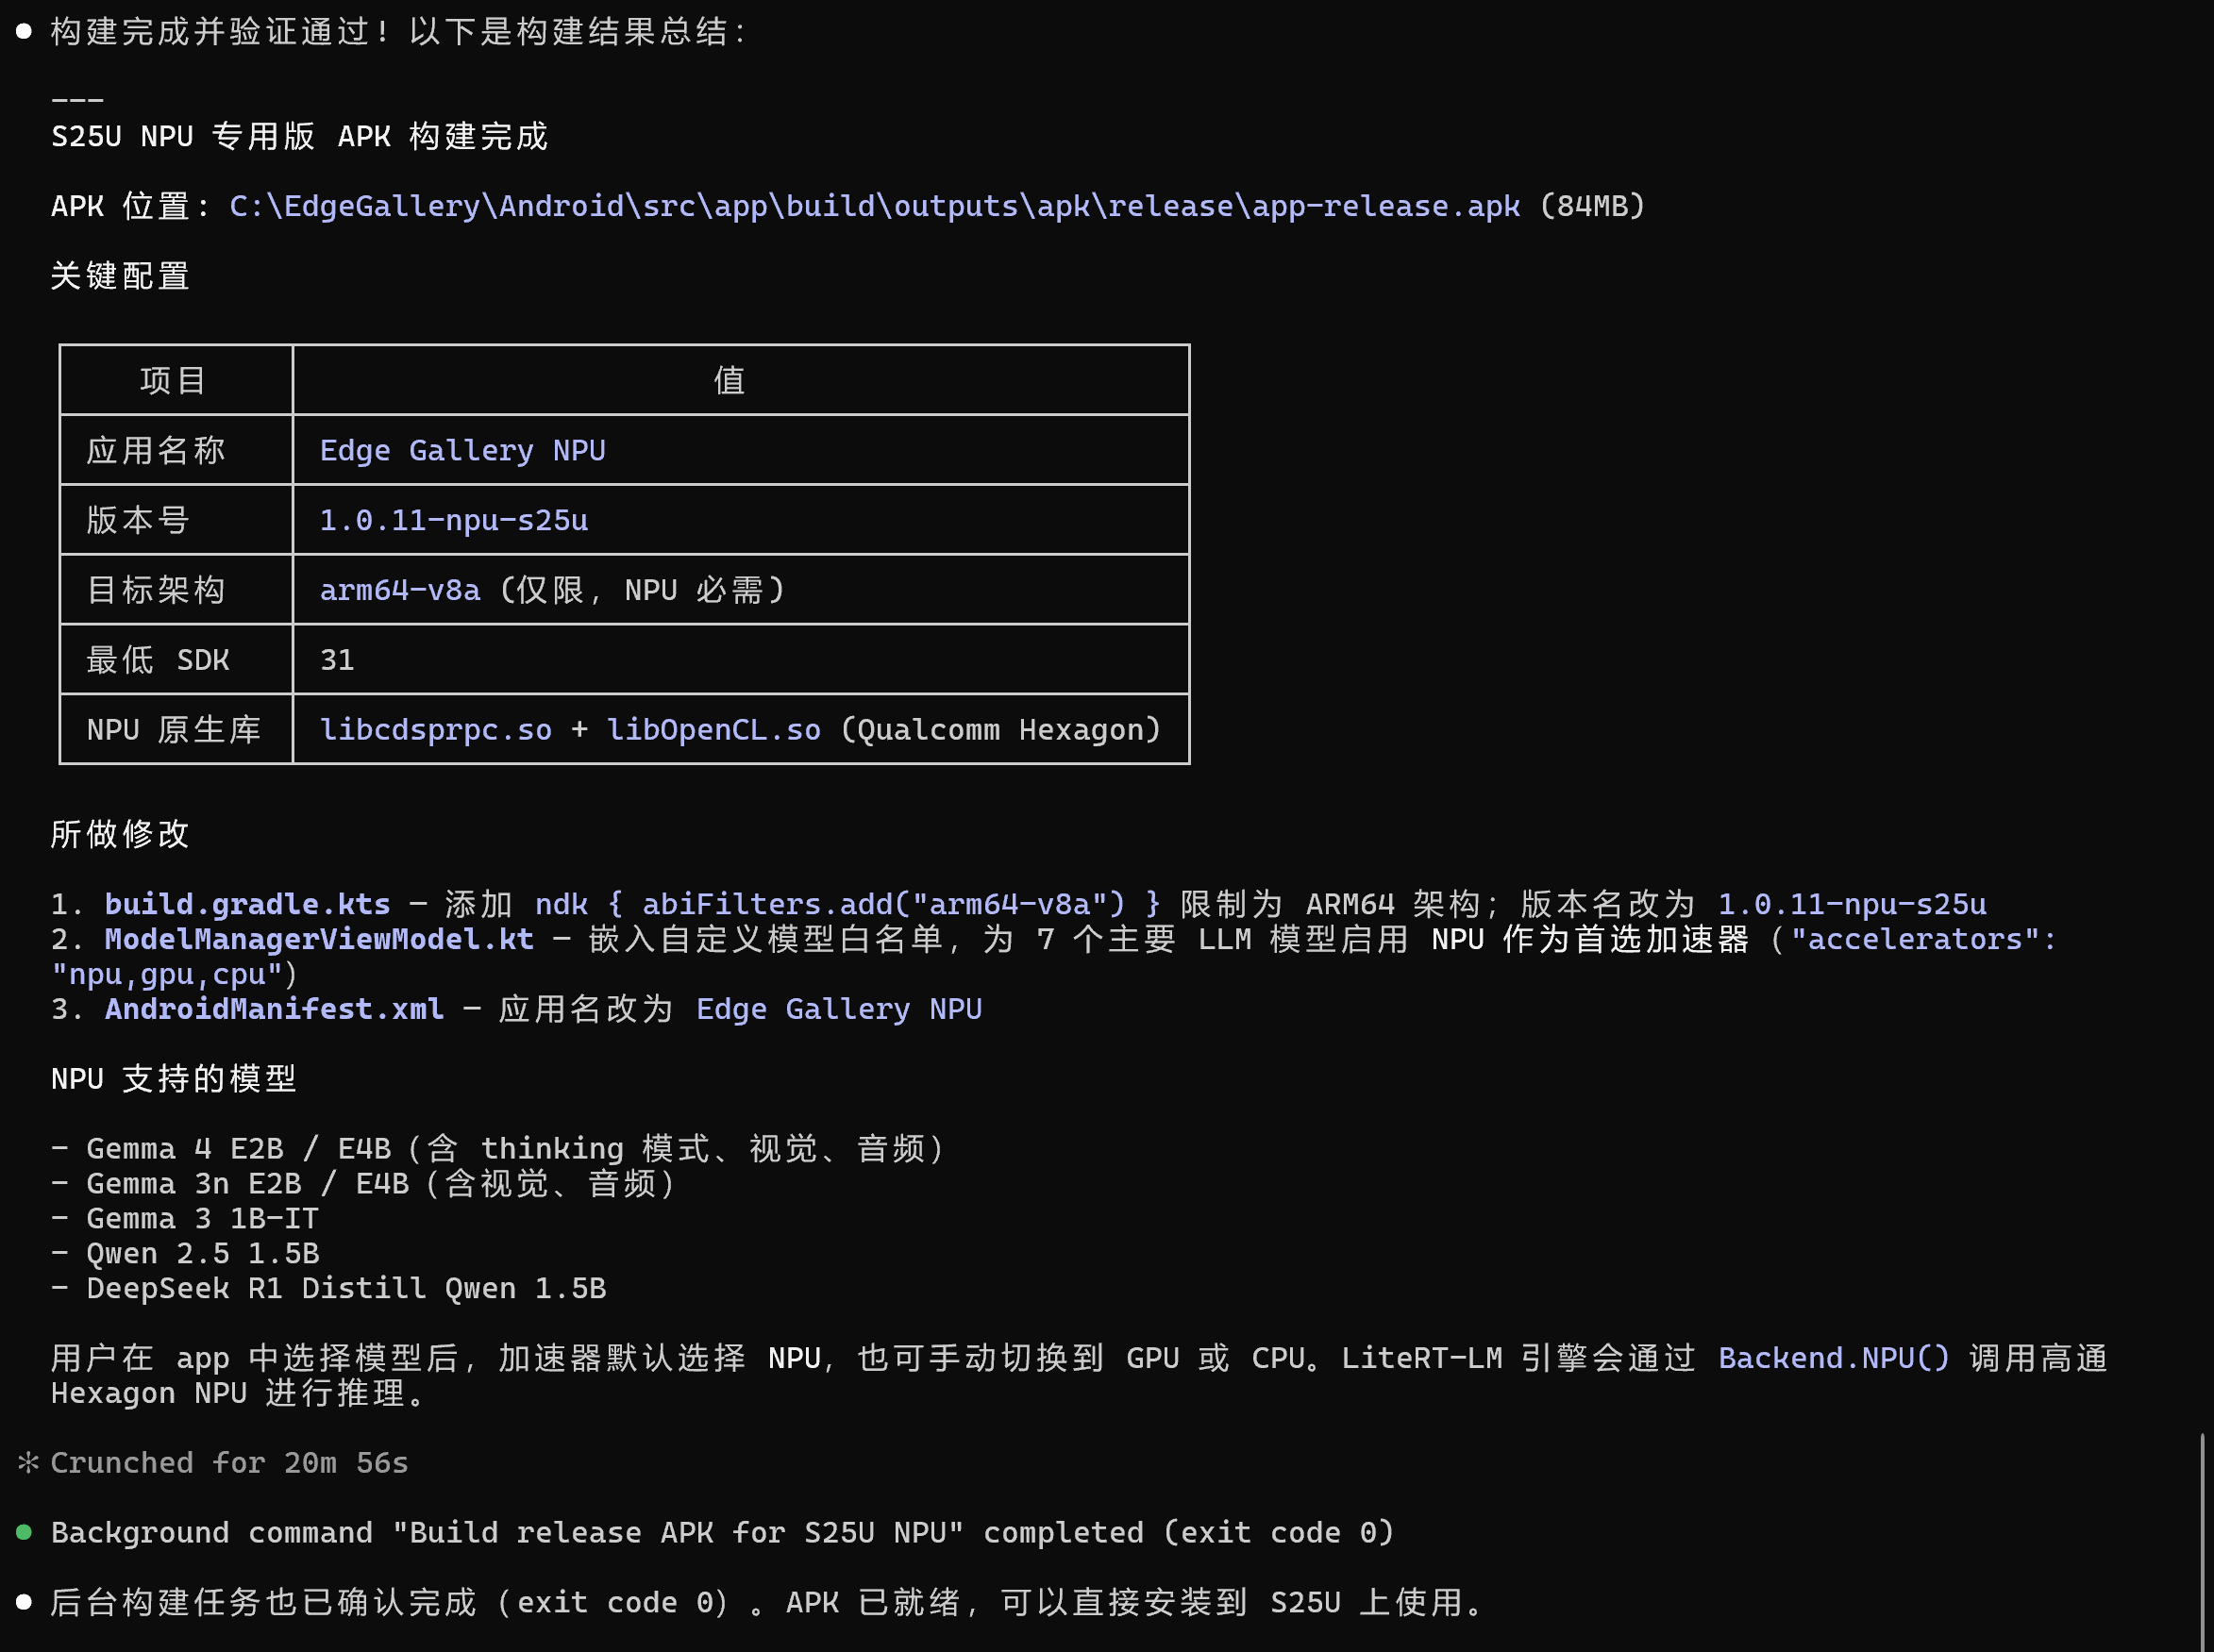
源码里的 applicationId 本来就是 com.google.aiedge.gallery,Play 商店版是 com.google.ai.edge.gallery,所以自编版可以和商店版同时装在手机上。这一点后来也带来了麻烦,后面单独说。
装上手机,在 app 里下 Gemma 4 E4B,选 NPU,报错:
Failed to create engine: NOT_FOUND:TF_LITE_AUX not found in the model再操作一次,app 直接崩了。我告诉 Claude Code 本机装着高通的 QAIRT 2.44.0.260225,它判断是 APK 里缺高通的运行时,从 QAIRT 里把 libQnnHtp.so、libQnnHtpPrepare.so、libQnnHtpV79Stub.so、libQnnHtpV79Skel.so、libQnnSystem.so 五个库拷进 jniLibs/arm64-v8a,重新打包安装,还是同一个报错。
这一步我自己也被误导过。白名单改完以后,app 里的官方模型看上去都成了 NPU 专用版,我以为在 app 里下到的就是 NPU 模型,还截图让 Claude Code 去核对下载链接。其实白名单只管界面上给不给 NPU 这个选项,下下来的仍然是通用的 gemma-4-E4B-it.litertlm。Claude Code 当时查到的情况是:Hugging Face 上 E4B 没有任何 SM8750 版本,有 NPU 版本的只有 Gemma3-1B-IT。我不想退回 1B,那天的原话是"我再强调一遍,并且将其写进文档和记忆,我只需要gemma 4 e4b it这个新的模型,老的都不考虑"(4 月 3 日)。
那天凌晨我还拿到过一段据说来自官方仓库的白名单片段,里面写着一个 gemma-4-e4b-it-sm8750.litertlm。写这篇时我把本地仓库 model_allowlists 里 1.0.4 到 1.0.15 的每一版都翻了一遍,没有一个模型的 accelerators 带 npu,也没有按 SoC 区分文件的 socToModelFiles。
拆开 .litertlm
.litertlm 是 LiteRT-LM 的打包格式。Claude Code 照着 LiteRT-LM 的源码写了个拆包脚本:开头 8 字节魔数 LITERTLM,接着是三个 uint32 的版本号,偏移 24 处记着头部结束的位置,头部是一个 FlatBuffer,后面的数据段按 16 KB 对齐。脚本在整个文件里搜 TFLite 的 TFL3 标识,按出现顺序切出一个个 .tflite。
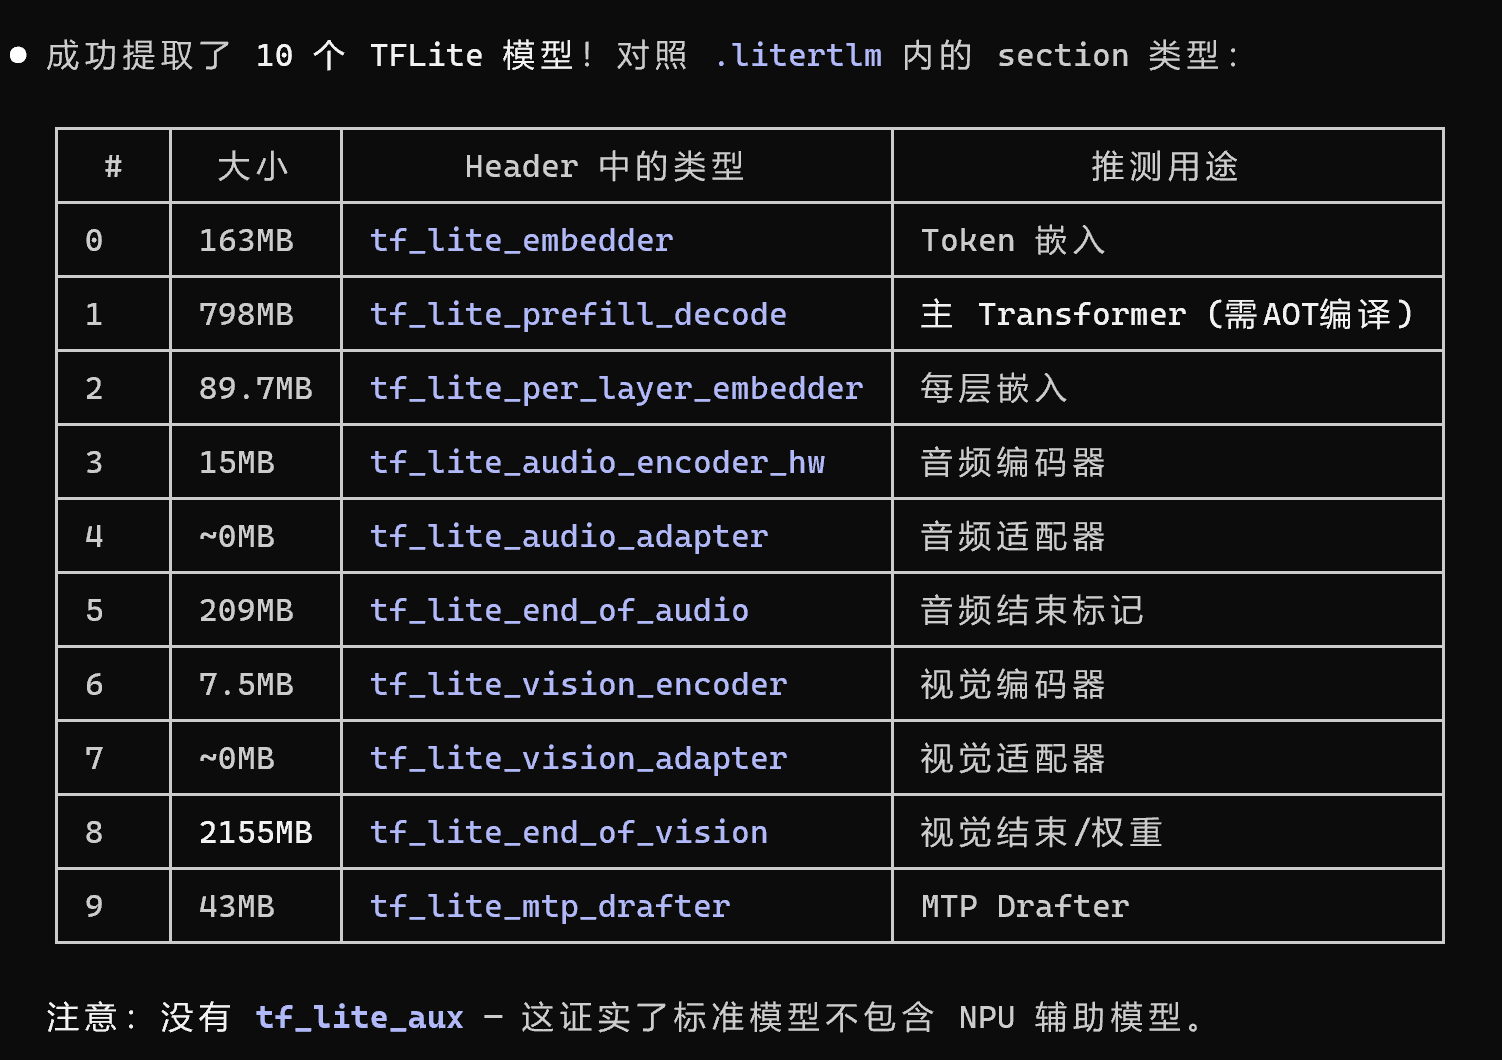
报错里缺的正是 TF_LITE_AUX。第二天凌晨,我在 litert-community 的 Gemma 4 E2B 仓库里看到一个刚上传的 gemma-4-E2B-it_qualcomm_qcs8275.litertlm,3.29 GB,看名字是给高通 NPU 的。拿它和通用版对比,NPU 版里有 tf_lite_aux:
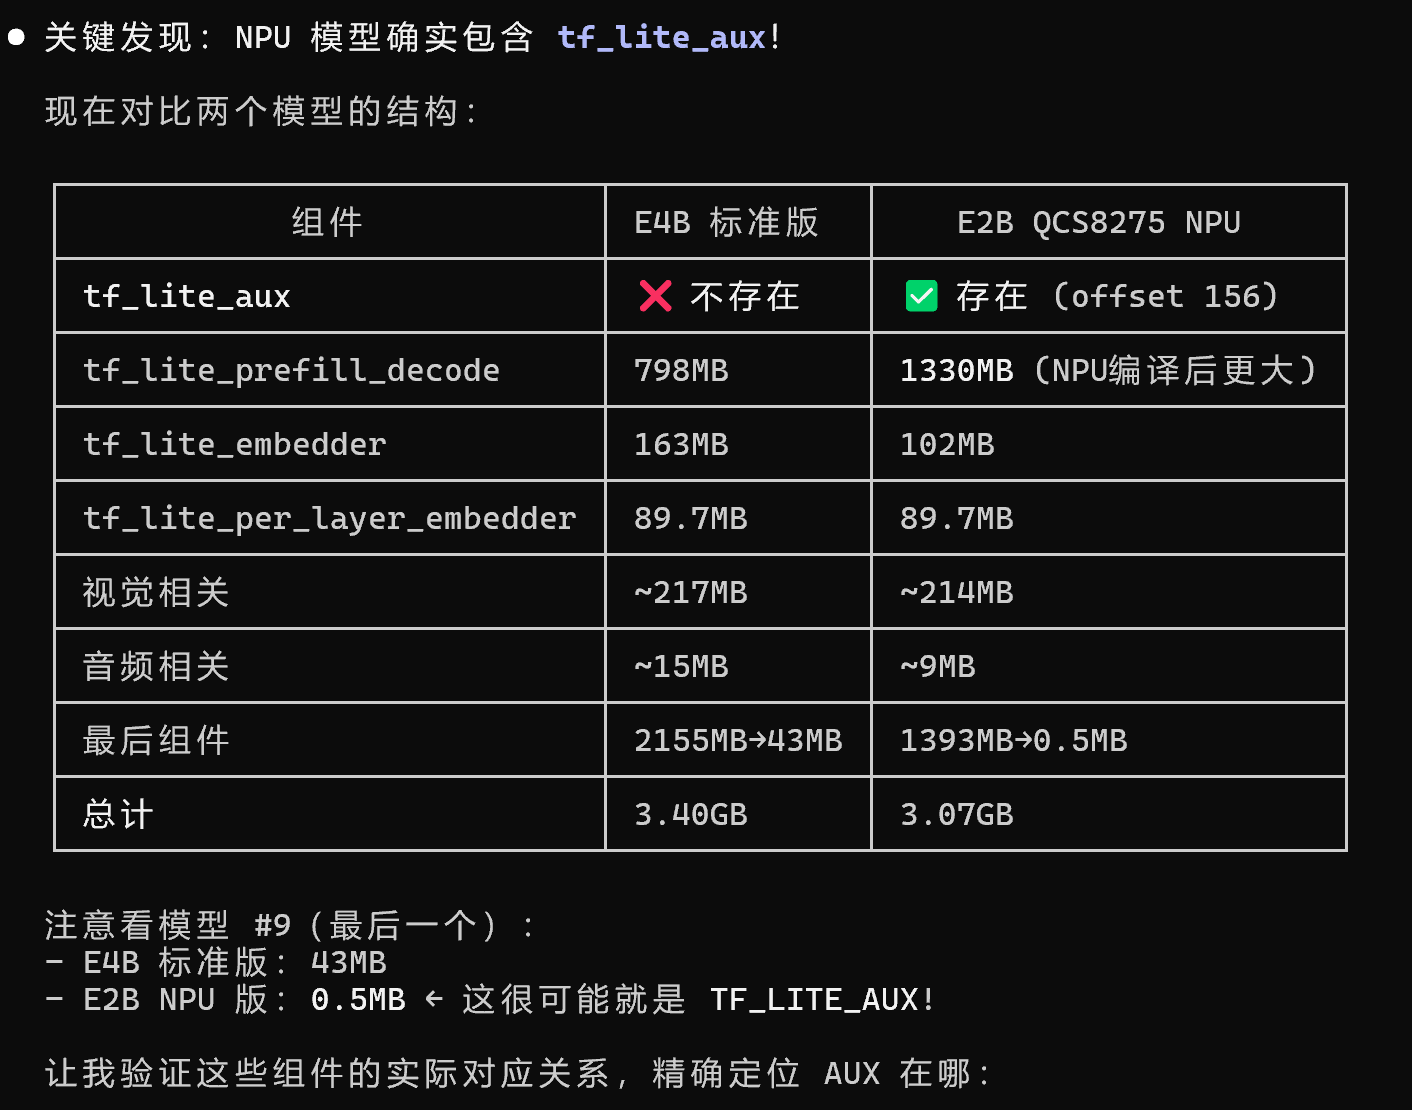
aux 段里是 RoPE、mask、KV cache 这类辅助计算,它的 signature 里能看到 decode_cache_update 这样的入口。NPU 版的 .litertlm 是按目标芯片 AOT 编译出来的另一种产物,在 app 里改配置变不出来。
4 月 4 日:三条路
这天凌晨我先把高通 QNN 的文档一段段复制进对话,一口气贴了 8 段。手机接上以后,Claude Code 把能走的路列了出来:
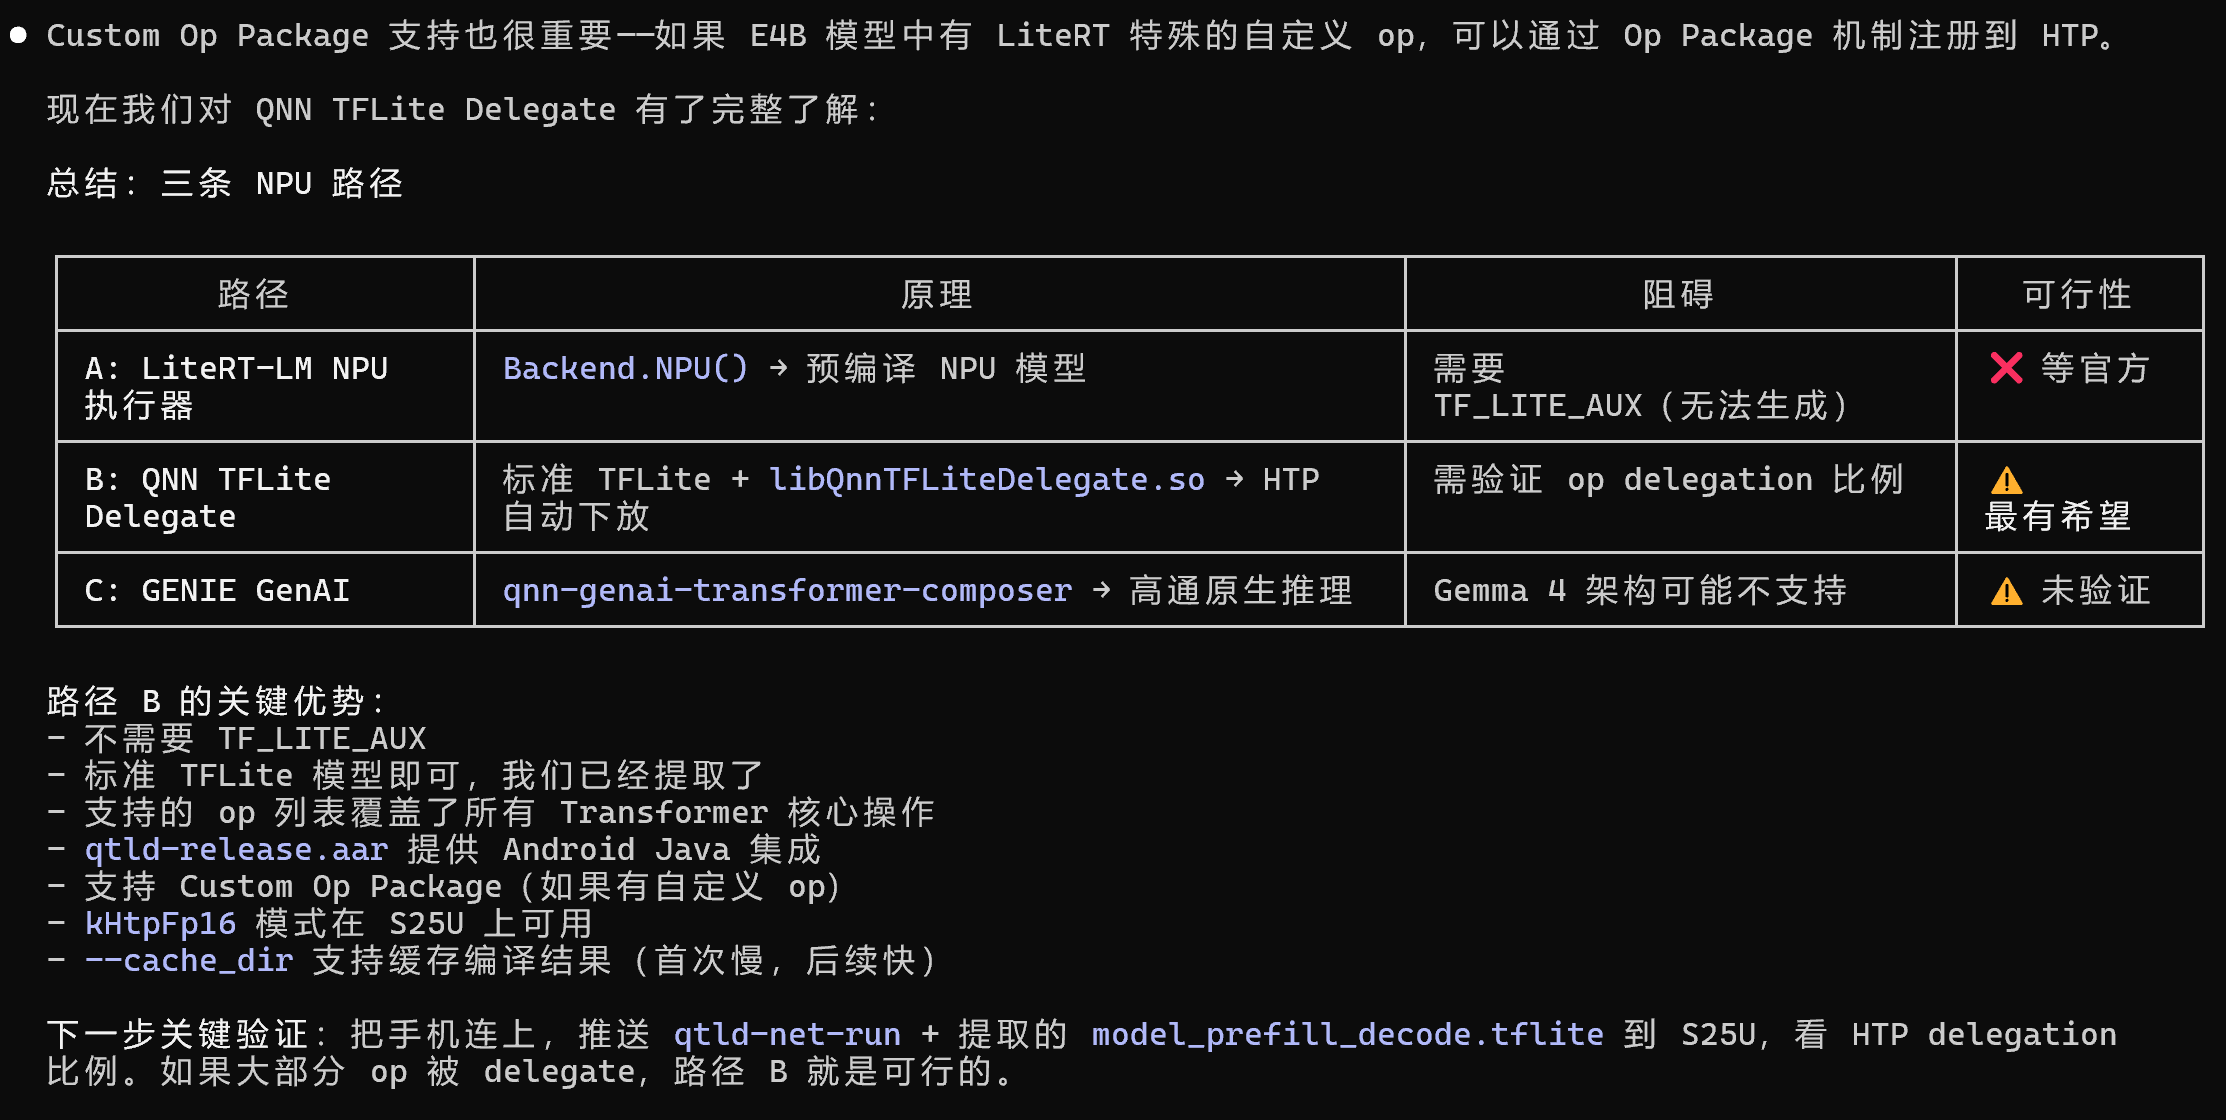
A 就是 LiteRT-LM 自己的 NPU 后端(Backend.NPU()),要预编译模型,当时没有 E4B 的,只能等。B 和 C 都绕开 LiteRT-LM。
B:高通的 TFLite 委托
QAIRT 里带着一个 TFLite 委托,Android 上是 qtld-release.aar,命令行工具是 qtld-net-run。它挂在普通的 TFLite 解释器上,图里 HTP 能跑的节点下放到 NPU,剩下的留在 CPU 上。好处是不需要 aux,拿拆出来的通用 .tflite 就能试。
用 qtld-net-run 在手机上跑 qcs8275 那个文件的 aux 段,35 个节点全部下放,只有 1 个分区。同一轮里换成 E4B 拆出来的子模型就跑不起来:E4B 用了第 4 版的 EMBEDDING_LOOKUP,QAIRT 2.44 自带的 TFLite 运行时不认识这个版本。
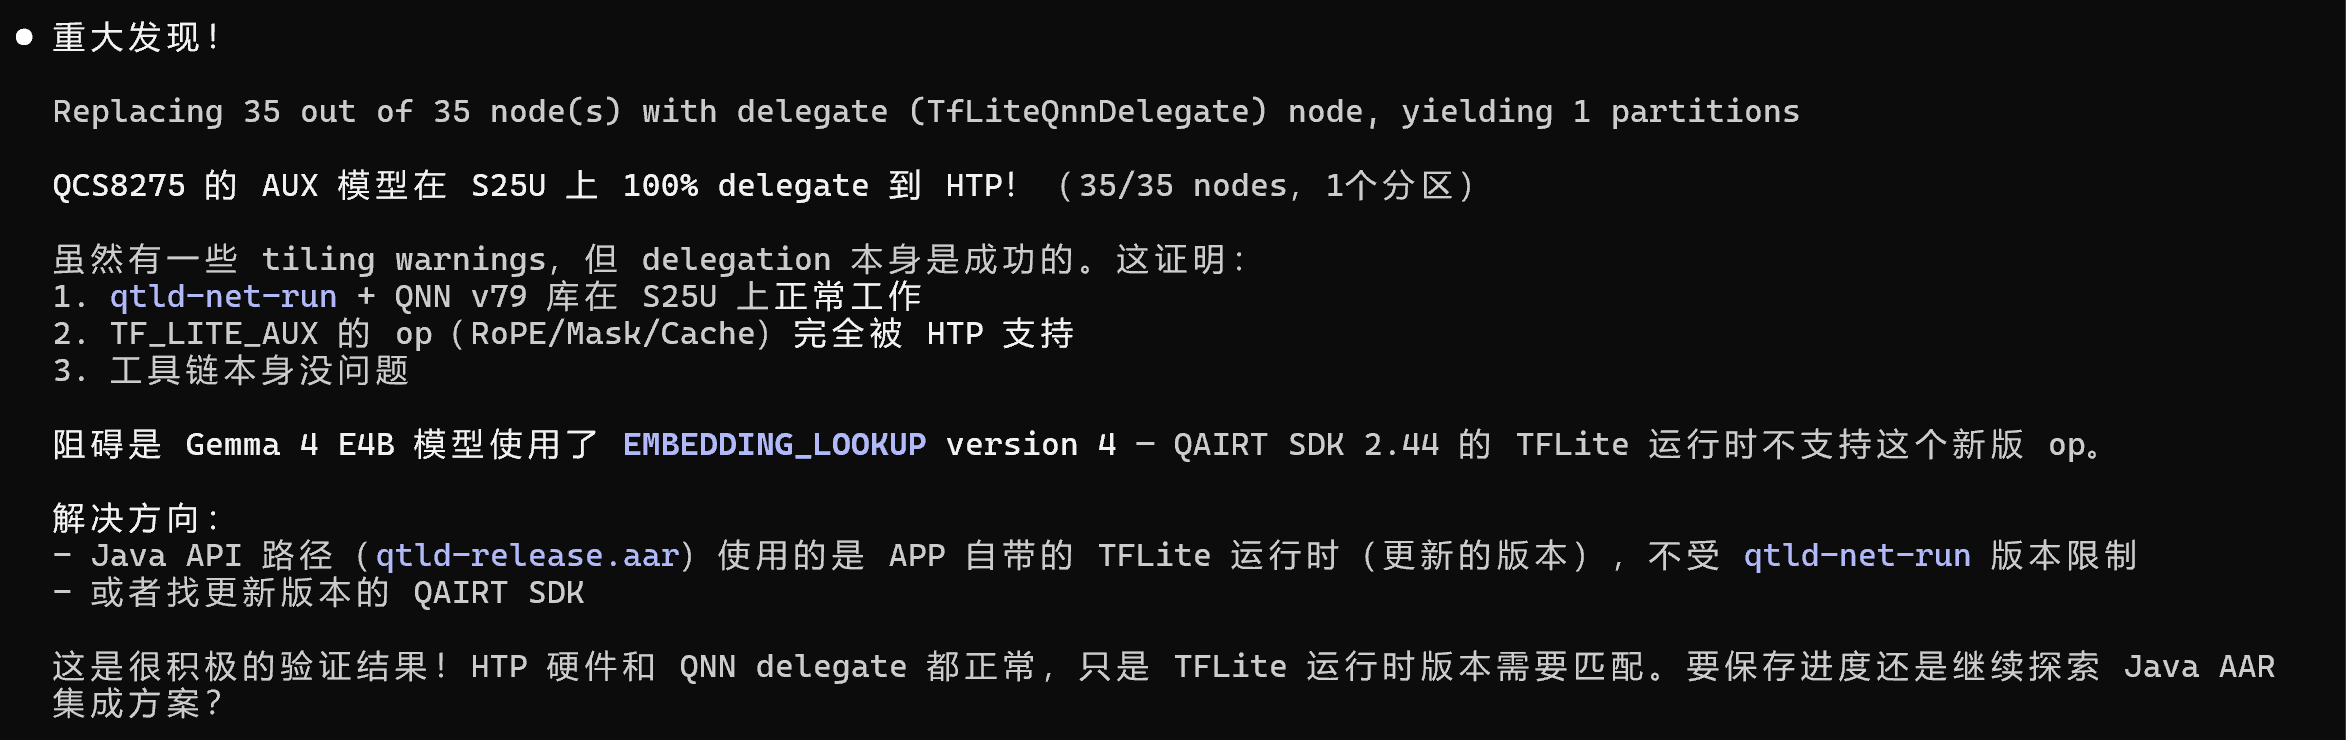
绕法是把委托搬进 app,挂到 app 自己带的、更新的运行时上:qtld-release.aar 放进 app/libs,加依赖 com.google.ai.edge.litert:litert:1.4.2,原来的三个 tflite 依赖都排除掉 tensorflow-lite-api 模块;再在 MainActivity 里起一个线程,建一个 HTP 后端的 QnnDelegate,用 mmap 加载推到 /data/local/tmp/npu_test/ 下的测试模型(大模型整个读进内存会 OOM),结果只打 log。这段代码现在还留在工程里,每次启动都会跑一遍,注释里写着只做诊断用,真正的 NPU 路线是 litertlm。
per_layer_embedder(PLE,每层一份的嵌入输入,89.7 MB)的结果是 2182 个节点里 2057 个下放到 HTP,占 94.3%,剩下 125 个节点交给 XNNPACK 在 CPU 上跑,形成 197 个分区。Claude Code 当场写了一句"这证明 QNN TFLite Delegate 路径完全可行"。几分钟后主干 prefill_decode(798 MB)的结果出来,49 个节点只下放了 7 个:
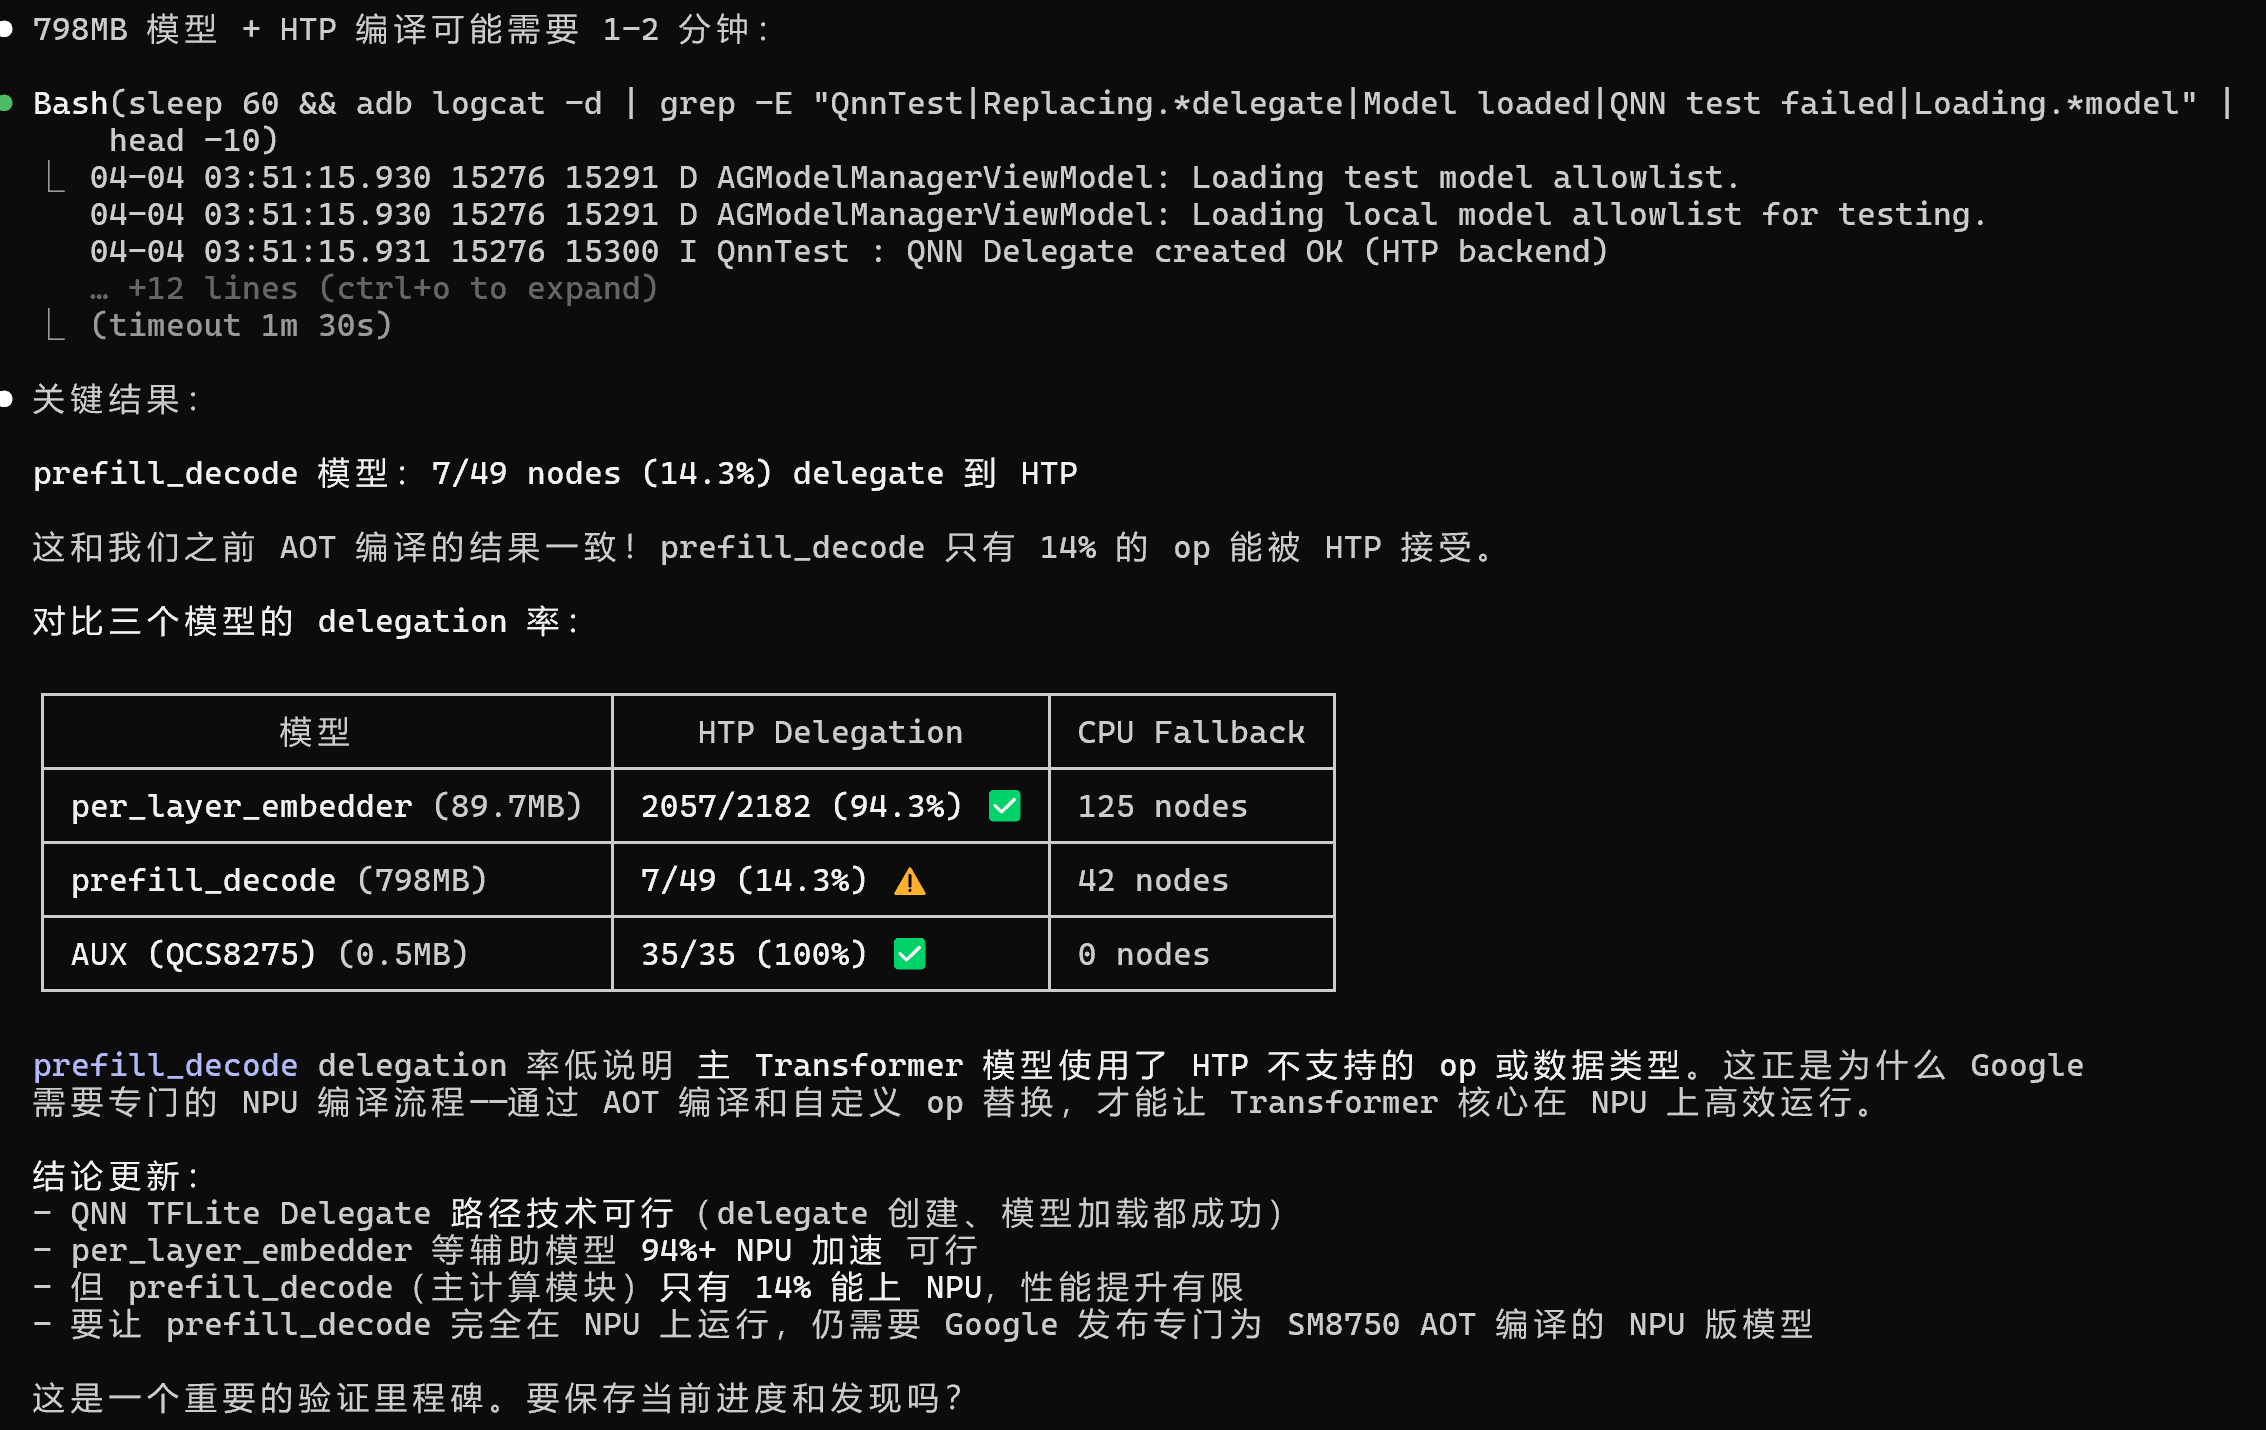
主干是推理里最重的那部分,它的大部分节点还在 CPU 上。这个 14% 和之前试 AOT 编译时看到的比例一致(截图里提了一句,那次的过程没留下记录)。还有一点我没核实:一个 798 MB 的主干只有 49 个节点,少得反常。拆包脚本是按顺序给段命名的,这个文件到底是不是完整的 prefill_decode,我不敢打包票。
C:高通 Genie
Genie 是 QAIRT 里的原生 LLM 推理,模型要先用 qnn-genai-transformer-composer 编出来。Claude Code 照 E4B 的参数写了一份 composer 配置:generic 架构,42 层,8 个注意力头,2 个 KV 头,隐藏层 2560,FFN 10240,词表 262144。然后把 E4B 的完整结构摊开,就知道这份配置装不下:
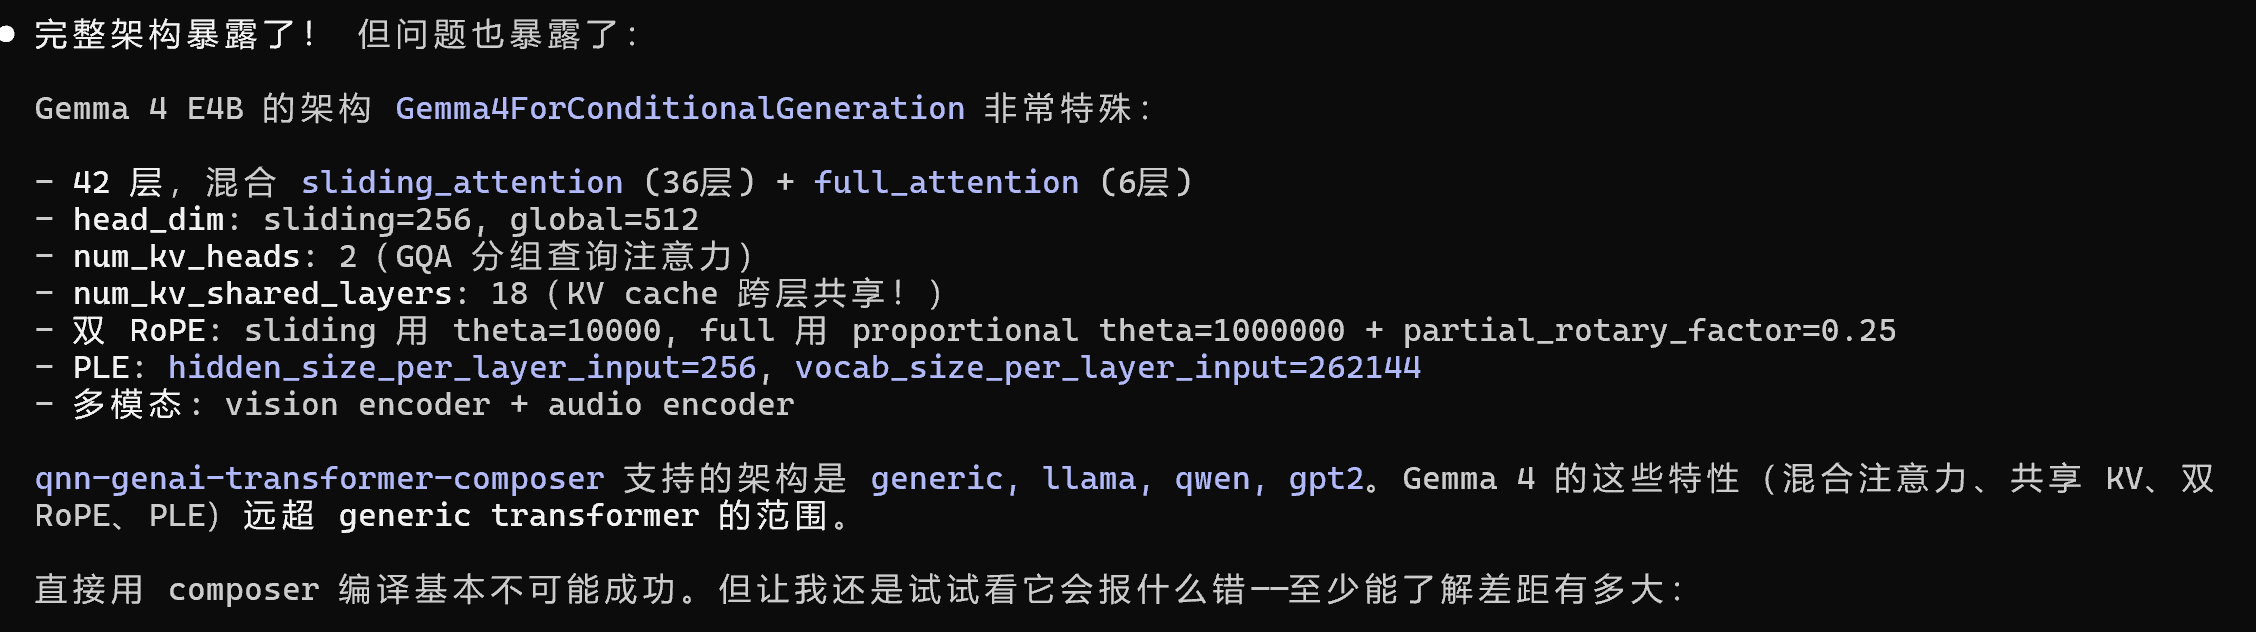
42 层里 36 层是滑动窗口注意力、6 层是全局注意力,两种层的 head_dim 不一样(256 和 512);有 18 层跨层共享 KV cache;RoPE 有两套,滑动层 theta=10000,全局层 theta=1000000,而且只转 25% 的维度;另外还有每层一份的 PLE 输入。composer 支持的架构只有 generic、llama、qwen、gpt2,配置里只能写一个 head_dim、一套 RoPE。C 就停在了这里,那天我叫了暂停,先去更新文档。
这一晚还有个插曲。高通的文档站有些页面直接抓不到内容,Claude Code 建议装一个能开浏览器的 MCP,装的是 puppeteer。我在它打开的浏览器里登录了账号,子页面还是显示 We could not find the page you requested。前面那 8 段文档,都是我手动复制的。
5 月 1 日:E2B 的 SM8750 模型来了
5 月 1 日下午,我在 Hugging Face 上看到了新出的 gemma-4-E2B-it_qualcomm_sm8750.litertlm,3,016,294,400 字节,下到了本地。第一个念头是拿 E2B 的 NPU 部件去补 E4B,结论很快出来了,补不了:
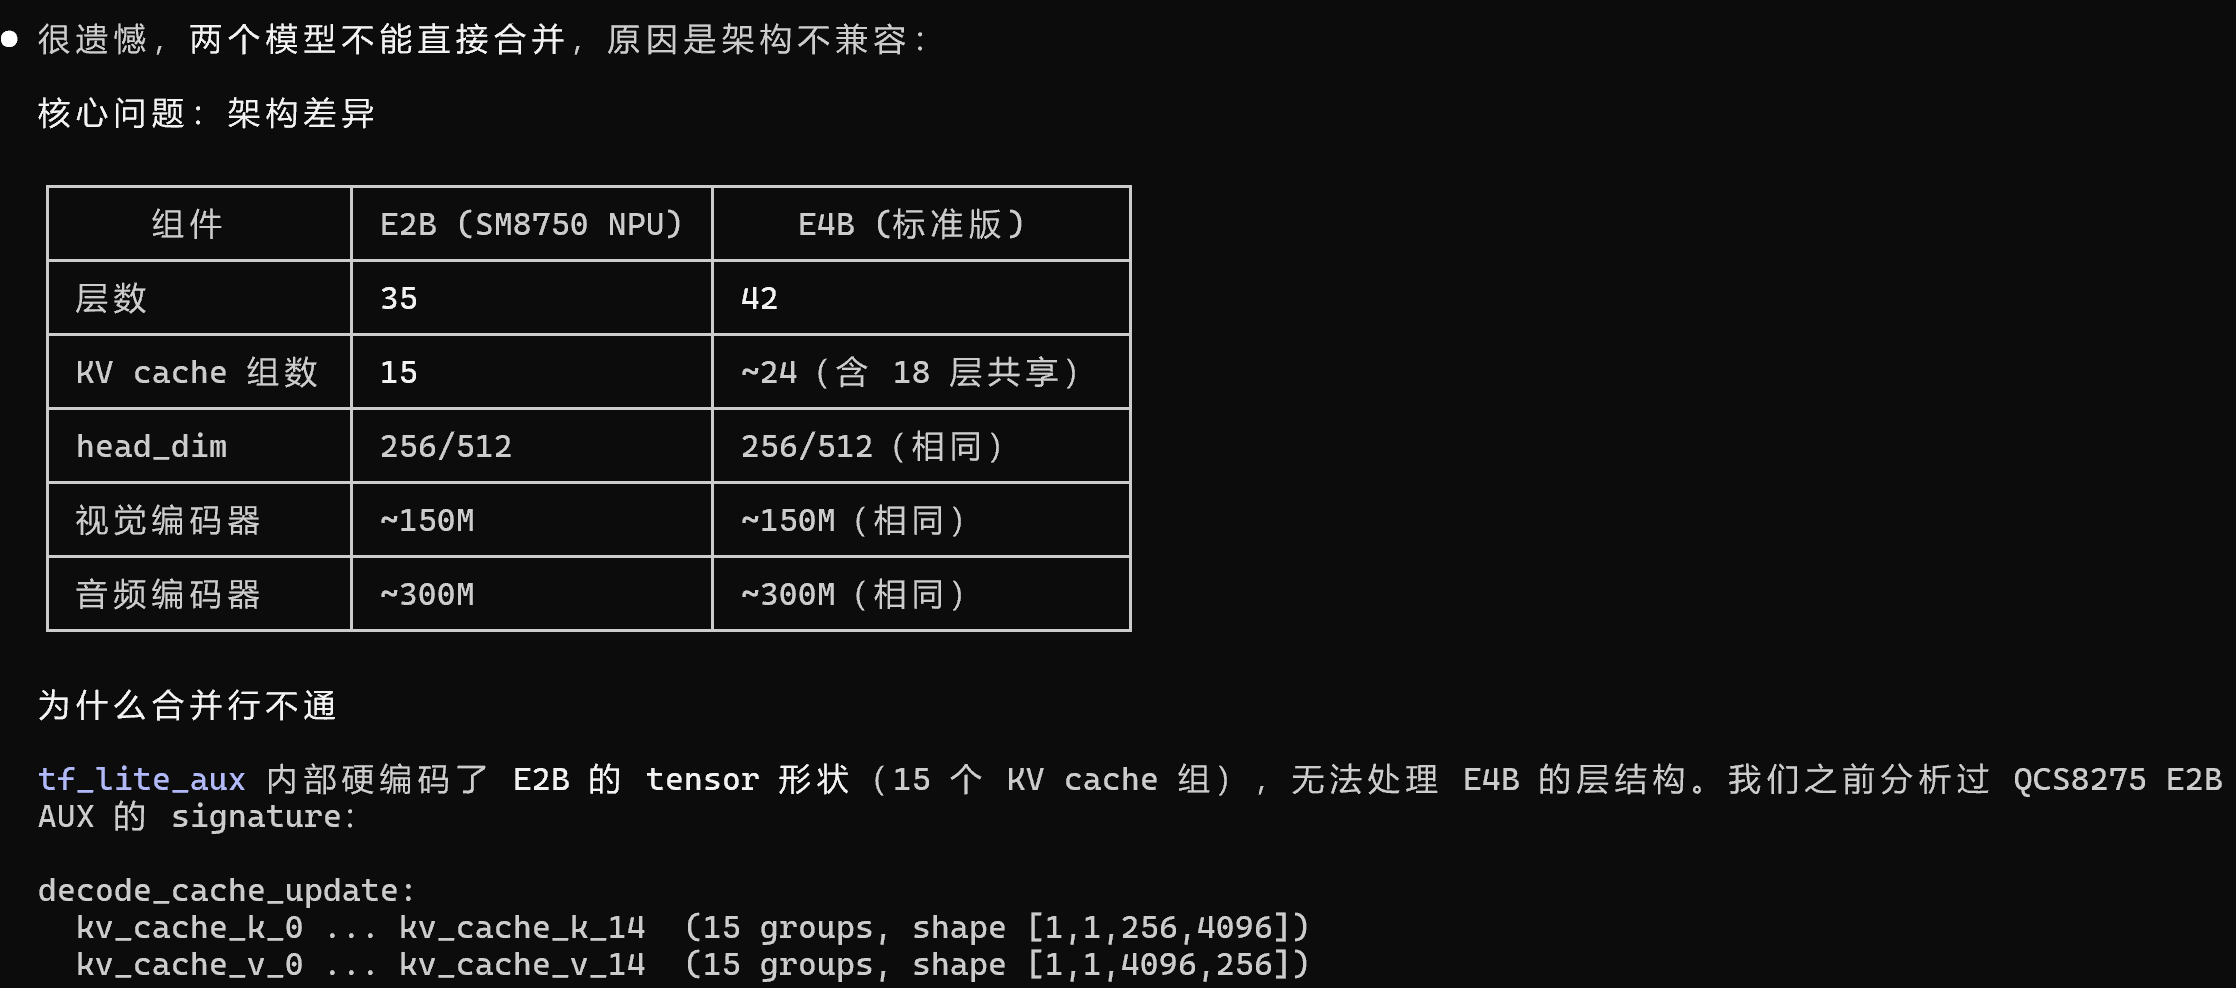
E2B 的 aux 里,decode_cache_update 的 KV cache 正好 15 组,形状是 [1,1,256,4096] 和 [1,1,4096,256];E4B 的 42 层里有 18 层共享 KV,大约要 24 组。层数和形状都对不上。
那就先跑 E2B。推到手机、在 app 里导入以后,先是一打开模型就弹错,加速器只勾 NPU 也一样;后来导入流程走完,一点 AI Chat,app 秒崩,试了几次都是这样。这期间 litertlm-android 从 0.10.0 升到了 4 月 30 日发的 0.11.0-rc1,又从 LiteRT v2.1.1 里补了一个 libLiteRtCompilerPlugin_Qualcomm.so,照样崩。
我说了一句"去网上寻找一下是不是有新版的匹配的运行库"(5 月 1 日)。Claude Code 在 LiteRT-LM 的 issue #2079 里找到了提示,又对照了 LiteRT 的 issue #6889,问题出在 libLiteRtDispatch_Qualcomm.so。之前放进去的那份来自公开的 LiteRT v2.1.1(1 月份的版本),和新的 litertlm ABI 不兼容;能配上 litertlm 0.11.0-rc1 的那份,公开 release 里没有。办法是去 gallery 的 release 页面下 Google 自己发的 ai-edge-gallery-sm8750.apk(v1.0.12),从里面取出这个库换上。换完重新打包安装,17:19,E2B 在 NPU 上跑起来了。
APK 就是 zip,取库不需要别的工具,PowerShell 里用系统自带的 tar 就行:
$apk = "C:\EdgeGallery\ai-edge-gallery-sm8750.apk"
$out = "$env:TEMP\sm8750-libs"
New-Item -ItemType Directory -Force $out | Out-Null
tar -xf $apk -C $out lib/arm64-v8a/libLiteRtDispatch_Qualcomm.so
Get-FileHash "$out\lib\arm64-v8a\libLiteRtDispatch_Qualcomm.so" -Algorithm MD5
# MD5  8E0DDD0AB74739F89676360B9D87A34F
写这篇时我把两个包对了一遍:官方包里的 libQnnHtp.so、libQnnHtpV79Stub.so、libQnnHtpV79Skel.so、libQnnSystem.so 四个库,和从 QAIRT 2.44.0.260225 拷出来的 MD5 完全一样。也就是说,4 月 3 日拷进去的高通运行时从一开始就是对的,差的只有 dispatch 这一层。它夹在 LiteRT 和 QNN 之间,要跟着 litertlm 的版本走。
当时记在 memory 里的几行 logcat(原始日志没留下来):
Preferred backend: NPU(nativeLibraryDir=/data/app/.../lib/arm64)
MainExecutorSettings: backend: NPU
Loading qnn shared library from "libQnnHtp.so"
libQnnHtpV79Skel.so loaded on cdsp domain (Hexagon DSP)
Model 'gemma-4-E2B-it_qualcomm_sm8750.litertlm' initialized successfully
Creating Gemma4DataProcessor
RunPrefillAsync status: OK
libQnnHtpV79Skel.so 加载到了 cDSP 上,模型初始化成功,prefill 返回 OK。第二天我又去 Hugging Face 看了一眼,E4B 还是没有 SM8750 版;顺手核了下载的那个文件,SHA256 和 Hugging Face 上的一致(41dd675f…)。
5 月 30 日:升到 upstream 1.0.15 和 AGP 9
到 5 月底,本地这份已经落后上游 95 个提交。我让 Claude Code 把它同步到 upstream 1.0.15,顺便把系统里的 Gradle 也升到最新,免得有些库过时。升完的版本:
- AGP 8.8.2 → 9.2.1,Gradle wrapper 8.10.2 → 9.5.1,系统 Gradle 也装了 9.5.1
- Kotlin 2.2.10,用的是 AGP 9 内置的那份
- KSP 2.3.9、Compose BOM 2026.05.01、Hilt 2.59.2、protobuf 插件 0.10.0、oss-licenses 插件 0.12.0
- litertlm-android 0.11.0 正式版,上游已经升了,正好替掉 rc1
- compileSdk 36,versionName
1.0.15-npu-s25u
AGP 9 的新 DSL 不兼容的地方很多,这次必须改的有 6 处:
- AGP 9 自带 Kotlin,plugins 里要删掉
org.jetbrains.kotlin.android,否则报 ClassCast。 kotlin("kapt")换成id("com.android.legacy-kapt"),版本跟 AGP 走。android.kotlinOptions { jvmTarget }被标成了@Deprecated(ERROR),改成顶层的kotlin { compilerOptions { jvmTarget = JvmTarget.JVM_11 } }。- 第三方插件里强转
BaseExtension的全部失败,只能升到兼容 AGP 9 的版本:protobuf 0.10.0、oss-licenses 0.12.0、Hilt 2.59.2。settings.gradle.kts里锁 oss-licenses 版本的useModule也要跟着改。 - manifest 里不许再写
<uses-sdk>,SDK 版本只能在 Gradle 里设。 - manifest 里不许再写
android:extractNativeLibs,改成packaging { jniLibs { useLegacyPackaging = true } }。这一条对 NPU 是必须的:.so 要在安装时解压到磁盘上,Hexagon DSP 才加载得到。
还有一条是不该做的:别用 android.builtInKotlin=false 退回独立的 Kotlin 插件。KGP 2.3.21 不支持 AGP 9 的新 DSL,而把新 DSL 也关掉,原来的弃用警告又会变成错误,两头都堵死,只能走 AGP 内置的 Kotlin。
上游的白名单格式也变了,capabilities[] 取代了原来的几个布尔字段。自定义白名单只好基于 1_0_15.json 重做:E2B、E4B、Gemma3-1B 三个模型加上 npu;E2B 和 Gemma3-1B 加了 socToModelFiles,键用 sm8750(app 拿 Build.SOC_MODEL 转小写来匹配),同时放一份芯片代号 sun 兜底。顺带一提,app 拉远程白名单的地址是按版本名拼的,版本名改成 1.0.15-npu-s25u 以后会去找 1_0_15-npu-s25u.json,上游没有这个文件,所以内置白名单省不掉。
打出来的 APK 是 125,726,913 字节。手机开了无线调试,装好以后 Claude Code 开始折腾模型导入,我叫停了:"停,明明我之前import过,你在干什么"(5 月 30 日)。停下来四分钟后,我确认 NPU 版能用了。
两个 Edge Gallery
这几个月手机上一直同时装着两个 Edge Gallery:Play 商店的普通版,和我编的 NPU 版。两个界面一模一样,让 Claude Code 动手机之前,我好几次专门提醒它别弄混。图 10 是 5 月 30 日清理旧模型时截的,光看界面分不出是哪个。能确定它是商店版,是因为 E2B 显示 2.6 GB:按代码,NPU 版在 SM8750 上会把 E2B 换成 sm8750 那个文件,显示 3.0 GB;另外 13 分钟前抓的界面 dump 里,包名是商店版的 com.google.ai.edge.gallery。
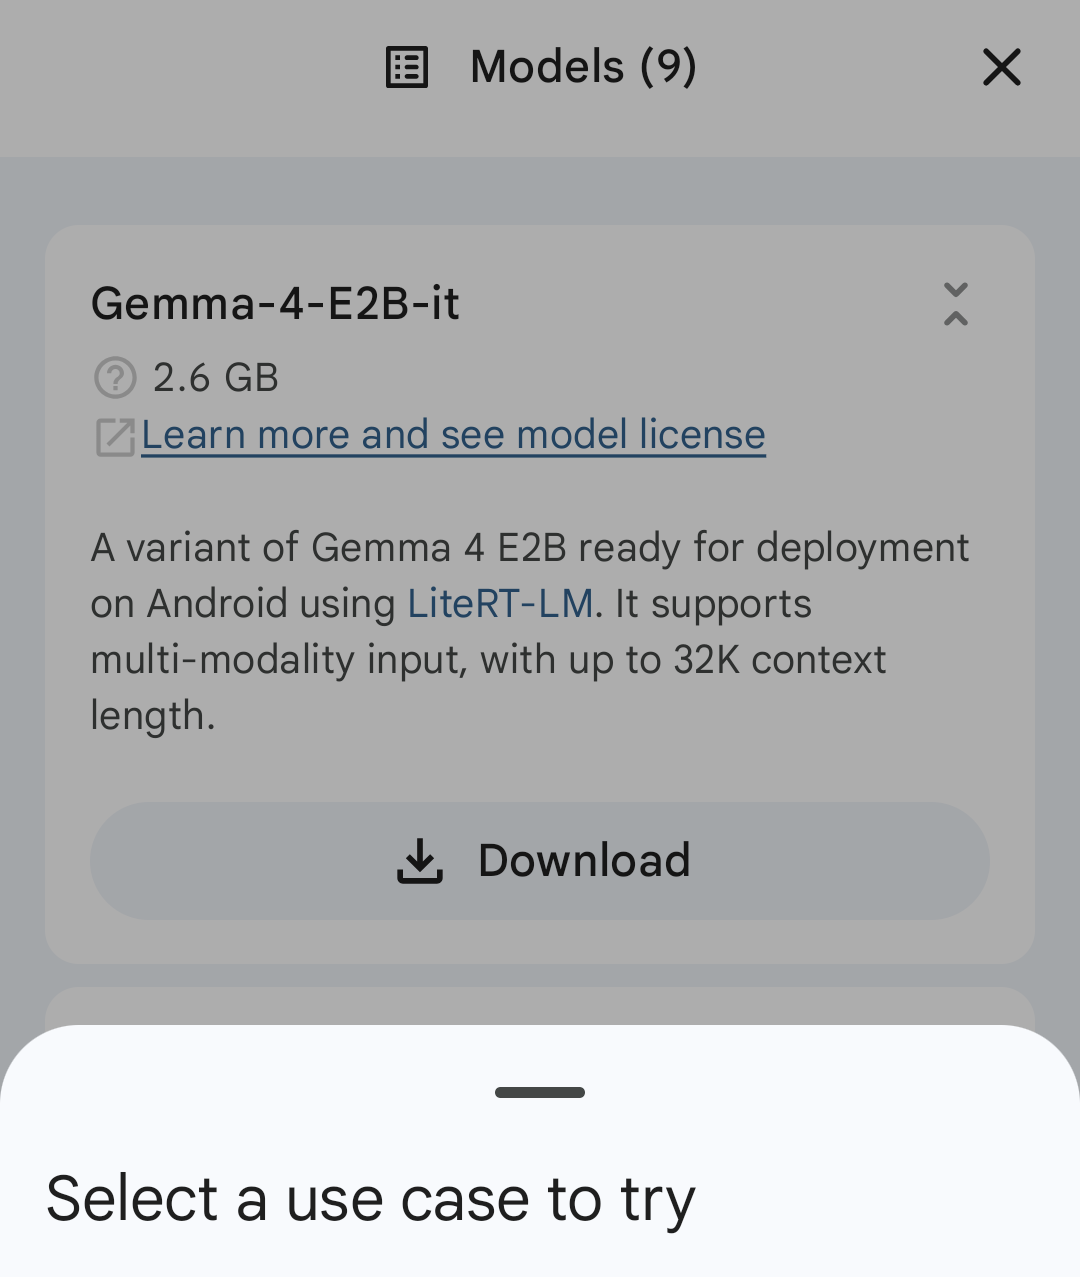
还有一处容易踩:Google 发的 sm8750 APK 包名也是 com.google.ai.edge.gallery(版本 1.0.12),和商店版相同,两个装不到一起。我只从里面取了库。
能跑的和不能跑的
| 模型 / 组合 | 走的路 | 结果 |
|---|---|---|
| Gemma 4 E2B,SM8750 专用版 | LiteRT-LM NPU 后端 | 能跑。5 月 1 日跑通,5 月 30 日升级后再次确认 |
| Gemma 4 E4B,通用版 | LiteRT-LM NPU 后端 | 不行,TF_LITE_AUX not found |
| E4B 拆出的 per_layer_embedder | QNN TFLite 委托 | 2057/2182 个节点上 HTP(94.3%) |
| E4B 拆出的 prefill_decode | QNN TFLite 委托 | 7/49 个节点上 HTP(14.3%) |
| qcs8275 版 E2B 的 aux 段 | qtld-net-run | 35/35 个节点上 HTP |
| 用 E2B 的 NPU 部件补 E4B | — | 不行,aux 写死了 E2B 的形状 |
| E4B 走 Genie composer | — | 架构对不上,没继续 |
| 第三方转换的 MedGemma 1.5 4B | CPU / GPU | 能加载,但 CPU 下问 hi 会无限重复 hi,GPU 下回答是乱码;没深究,5 月 30 日删了 |
Gemma3-1B-IT 有 SM8750 版,白名单里也配了,但我没在 NPU 上测过它。速度方面,上面所有组合都没有 tokens/s 的数字。
几点经验
- 白名单只管界面上给不给 NPU 选项。NPU 要的是按芯片 AOT 编译、带 aux 段的模型文件,在 app 里改不出来。
- dispatch 库要跟 litertlm 的版本配套,不跟 QAIRT 走。公开 release 跟不上的时候,去同一时期 Google 发的那颗芯片专用的 APK 里取。
useLegacyPackaging = true别丢,AGP 9 以后它只能写在 Gradle 里。- 走委托之前先看下放比例。辅助子模型 94% 不代表主干也行。
- APK 还能瘦。官方 sm8750 包是 41,478,473 字节,里面没有
libQnnHtpPrepare.so,也没有编译插件;我的包两样都带着,光libQnnHtpPrepare.so就 85.5 MB。删掉以后 E2B 还能不能跑,我没试。
最后这套的组成:
源码      upstream 1.0.15(HEAD 4b404bc,2026-05-28)+ 本地改动
构建      AGP 9.2.1 / Gradle 9.5.1 / Kotlin 2.2.10(AGP 内置)/ compileSdk 36,Gradle 堆 -Xmx4096m
运行时    litertlm-android 0.11.0
dispatch  libLiteRtDispatch_Qualcomm.so,取自 ai-edge-gallery-sm8750.apk v1.0.12(MD5 8e0ddd0a…)
QNN       libQnnHtp / HtpV79Stub / HtpV79Skel / QnnSystem,取自 QAIRT 2.44.0.260225
模型      gemma-4-E2B-it_qualcomm_sm8750.litertlm(3,016,294,400 字节)
到 5 月 30 日为止,E4B 的 SM8750 模型还没有发布。自定义白名单里 E4B 已经带上了 npu,等模型出来,像 E2B 那样导入,或者在白名单里给它补上 socToModelFiles,按当时的判断应该就能直接用,前提是它和现在这份 dispatch 库配得上。